LLM Course của Hugging Face: ba chương đầu dạy FDE đi từ pipeline() đến fine-tuning
Khoá học miễn phí, có bản tiếng Việt, và bạn có thể đọc ba chương đầu như một thứ tự làm việc ở chỗ khách hàng: đặt baseline trước, soi dữ liệu sau, fine-tune cuối cùng.
Tóm tắt nhanh
- Mười tác giả của Hugging Face và cộng tác viên viết khoá này. Khoá học miễn phí, không quảng cáo, mã nguồn theo giấy phép Apache-2.0 và đã có bản dịch tiếng Việt.
- Có thể đọc ba chương đầu theo thứ tự một FDE làm việc ở chỗ khách hàng: pipeline() cho baseline, tokenizer để hiểu dữ liệu, Trainer cho fine-tuning.
- Mỗi chương cần khoảng 6-8 giờ một tuần. Theo nhịp đó, ba chương đầu là nền để bạn tự làm một dự án nhỏ trên dữ liệu thật.
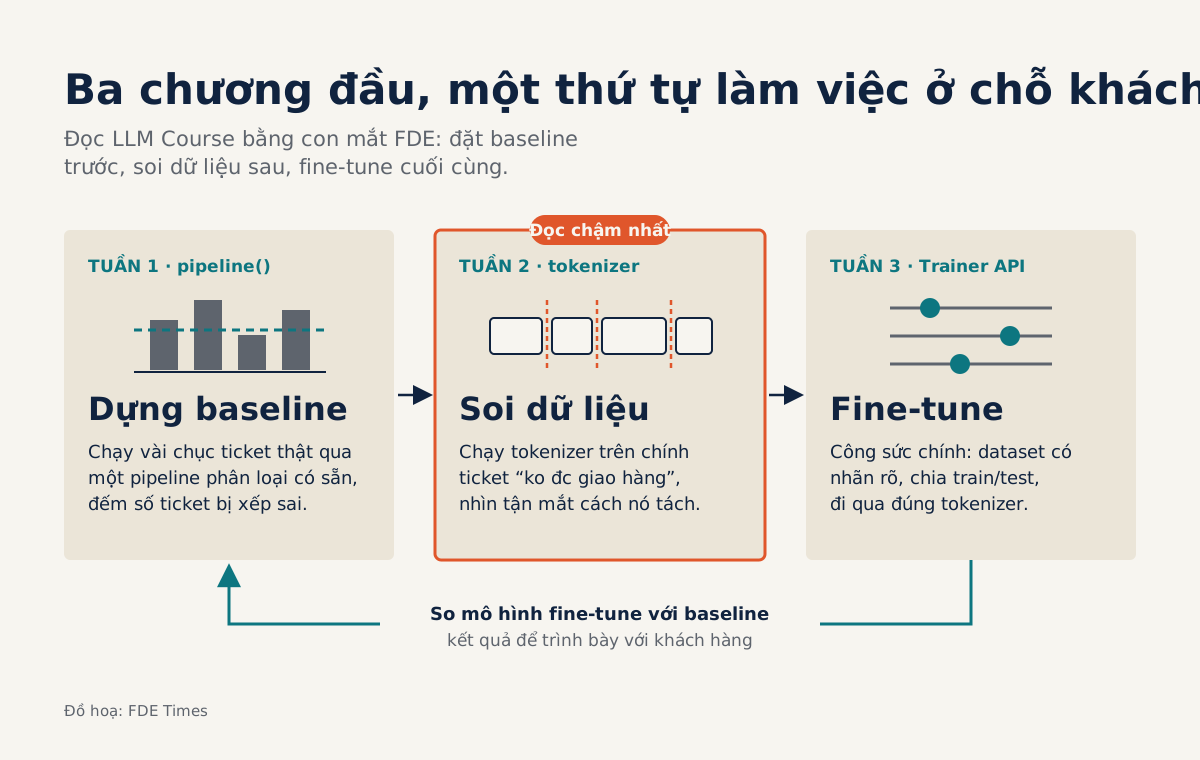
Thử hình dung một công ty logistics muốn tự động chia ticket chăm sóc khách hàng vào năm nhóm. Họ không hỏi bạn transformer là gì. Họ hỏi trong vài tuần tới có làm được một mô hình chạy trên dữ liệu của chính họ hay không.
Ba chương đầu trong LLM Course của Hugging Face trả lời gần đúng câu hỏi đó. Hugging Face không trình bày khoá học như một quy trình làm dự án, nhưng nếu đọc bằng con mắt FDE, thứ tự ba chương khớp với trình tự công việc ở chỗ khách: dựng baseline, soi dữ liệu, rồi mới fine-tune.
Khoá học miễn phí, không quảng cáo, mã nguồn mở theo giấy phép Apache-2.0, và bản tiếng Việt đã nằm trong danh sách các bản dịch hoàn thành. Với một developer Việt muốn chuyển sang FDE, rào cản để bắt đầu gần như bằng không.
Ai viết, và học với nhịp nào?
Nhóm tác giả gồm mười người của Hugging Face và cộng tác viên, trong đó có Sylvain Gugger, Lewis Tunstall, Leandro von Werra, Merve Noyan và Ben Burtenshaw. Trang chính thức tên là “Welcome to the 🤗 Course!”, còn phần trích dẫn ghi “The Hugging Face Course, 2022”.
README trên GitHub mô tả mục tiêu là dạy cách áp dụng Transformers cho nhiều tác vụ xử lý ngôn ngữ tự nhiên và cả những tác vụ khác. Nhịp học được đề xuất là mỗi chương một tuần, mỗi tuần khoảng 6-8 giờ.
Repo mở cho mọi người đọc, nhưng Hugging Face hiện không nhận đóng góp của cộng đồng cho chương mới. Với người học, chuyện đó không thay đổi gì: bạn đến đây để học và đọc code, và ba chương đầu đã đủ để bắt tay vào việc.
Ý thứ nhất: dựng baseline trước, chọn mô hình sau
Chương 1 dạy hàm pipeline() để giải các tác vụ như sinh văn bản và phân loại. Nghe thì đơn giản, nhưng đây là thói quen phân biệt một FDE với người chỉ làm demo.
Quay lại công ty logistics. Ngày đầu tiên, bạn chưa nên nói đến fine-tuning. Hãy lấy vài chục ticket thật, cho chạy qua một pipeline phân loại có sẵn rồi đếm xem bao nhiêu ticket bị xếp sai; con số đó là baseline, là mốc để mọi đề xuất sau này phải vượt qua.
Nếu baseline đã đủ tốt, bạn vừa tiết kiệm cho khách mấy tuần làm việc. Nếu chưa đủ, danh sách các câu bị đoán sai cho bạn biết cần sửa ở đâu.
Ý thứ hai: tokenizer là chỗ dữ liệu thật bị bóp méo
Chương 2 định nghĩa vai trò của tokenizer rất gọn: chuyển văn bản thành dữ liệu mà mô hình xử lý được. Sau đó chương này so sánh ba cách tách: theo từ (word-based), theo ký tự (character-based) và theo đơn vị nhỏ hơn từ (subword). Nhánh subword gồm BPE dùng trong GPT-2, WordPiece dùng trong BERT, và SentencePiece/Unigram.
Đây là chương nên đọc chậm nhất, vì dữ liệu của khách hàng không bao giờ sạch như dữ liệu trong ví dụ. Giả sử ticket logistics có câu như “ko đc giao hàng”, khách gõ không dấu, hoặc dán mã vận đơn vào giữa câu.
Về nguyên tắc, một tokenizer tách theo từ dễ gặp những từ nằm ngoài từ điển của nó. Tokenizer subword thì tách những từ lạ thành các mảnh mà nó đã biết, nhưng các mảnh đó có giữ được nghĩa hay không thì phải nhìn mới biết.
Việc nên làm đầu tiên là chạy tokenizer của mô hình định dùng trên chính những ticket đó, rồi nhìn tận mắt kết quả tách. Năm phút làm việc này có thể giải thích vì sao baseline sai, trước khi ai đó kịp đổ lỗi cho mô hình.
Ý thứ ba: fine-tuning chủ yếu là chuẩn bị dữ liệu
Chương 3 dạy fine-tuning bằng Trainer API cấp cao, theo những best practice hiện đại. Nhưng nửa còn lại của chương, chuẩn bị một dataset lớn từ Hub bằng các tính năng mới của 🤗 Datasets, mới là phần giống công việc thật nhất.
Trong ví dụ logistics, mất nhiều công nhất không phải là gọi Trainer. Mất công nhất là biến vài nghìn ticket lộn xộn thành một dataset có nhãn rõ ràng, chia train và test hợp lý, và đi qua đúng tokenizer bạn đã kiểm tra ở chương 2.
Khi đã làm xong phần này, chỉ cần so mô hình fine-tune với baseline ở chương 1. Kết quả so sánh đó chính là thứ để trình bày với khách hàng.
Ai nên học, và học theo thứ tự nào?
Hãy đi đúng thứ tự 1, 2, 3, mỗi tuần một chương.
Lý do rất thực tế: bạn chỉ biết mô hình fine-tune có đáng công hay không khi đã có baseline từ chương 1, và dataset ở chương 3 phải đi qua tokenizer bạn đã hiểu ở chương 2.
Có bản tiếng Việt là một lợi thế, nhưng nên dùng hai bản song song. Đọc bản tiếng Việt để nắm khái niệm, còn code và tên API thì đọc bản tiếng Anh, vì tài liệu, issue và câu hỏi của khách hàng sau này đều dùng thuật ngữ tiếng Anh.
Khi đọc mô tả công việc, hãy để ý các cụm như Transformers, fine-tuning, tokenization hay Hugging Face. Trong CV, đừng ghi “hoàn thành khoá học”. Hãy ghi một dự án gồm ba bước: baseline bằng pipeline, phân tích tokenizer trên dữ liệu thật, rồi một mô hình fine-tune vượt được baseline, kèm con số đo được và link repo.
Một chứng chỉ chỉ cho thấy bạn đã học. Một dự án làm đúng thứ tự ba chương này cho thấy bạn biết bắt đầu từ đâu khi đến chỗ khách hàng.