 OpenAI
Đổi model qua OpenRouter: hai dòng code và một bộ eval
Chunk usage khi streaming, provider được chọn theo giá rẻ, fallback lẫn model: ba cái bẫy này không báo lỗi nhưng có thể làm sai kết quả trước khi ai kịp nhận ra.
09/10/2026
Tờ báo của nghề Forward Deployed Engineer
Công cụ FDE dùng hằng ngày để triển khai, tích hợp dữ liệu và đánh giá AI tại khách hàng.
Chunk usage khi streaming, provider được chọn theo giá rẻ, fallback lẫn model: ba cái bẫy này không báo lỗi nhưng có thể làm sai kết quả trước khi ai kịp nhận ra.
09/10/2026
Nếu bạn vẫn sửa từng chữ trong prompt mỗi lần khách đổi model, có một cách làm khác: định nghĩa thế nào là đúng, rồi để thuật toán đi tìm câu chữ.
Ở site khách, FDE hiếm khi được chọn công cụ ETL, mà phải tiếp quản một pipeline đã chạy sẵn. Vì vậy, việc đầu tiên là đọc hiểu nó trước khi sửa bất cứ thứ gì.
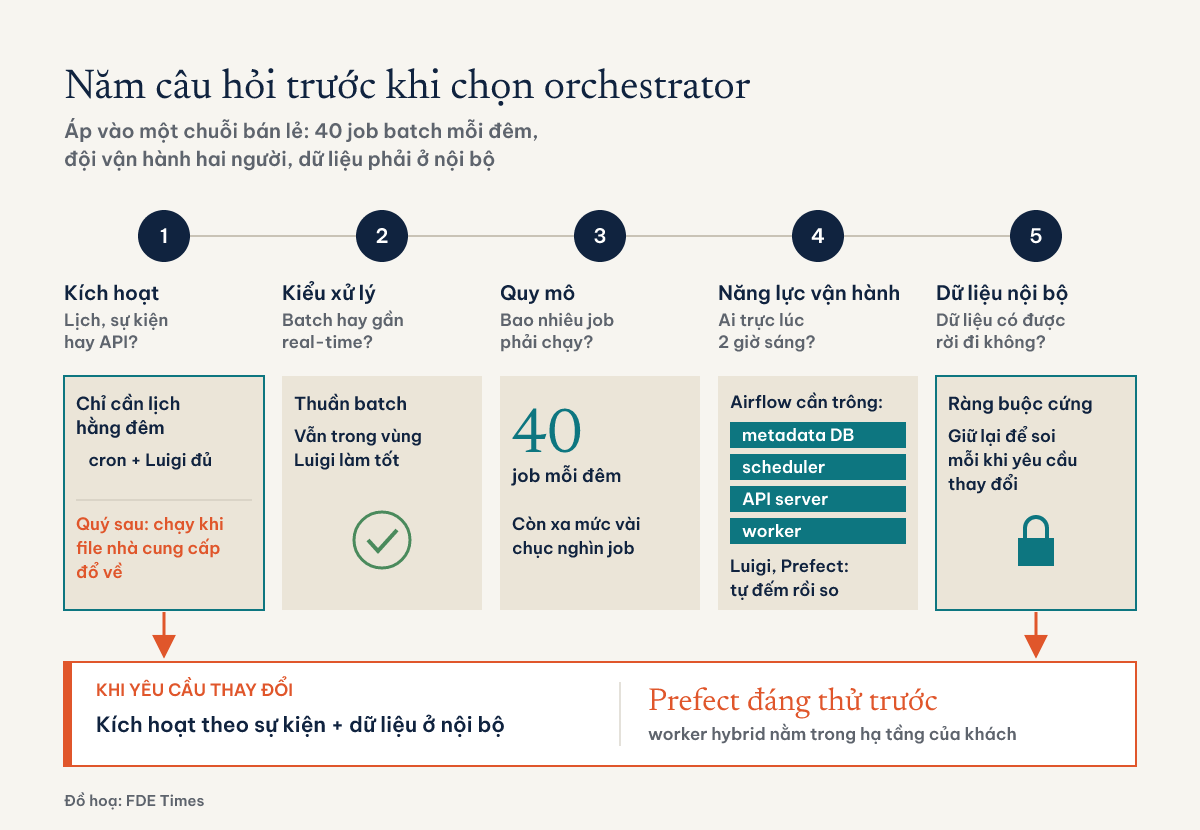
Chọn orchestrator thật ra là quyết định xem đội của khách phải vận hành những gì sau khi FDE rời đi, chứ không phải đi tìm công cụ nhiều tính năng nhất.
Cùng một file YAML có thể sinh tài liệu, mock server, client và cả tool cho agent, nếu bạn viết nó cho hai kiểu người đọc rất khác nhau.
Tài liệu khách gửi cho biết API lẽ ra phải chạy thế nào. Vài request đầu tiên mới cho biết nó thật sự chạy ra sao.
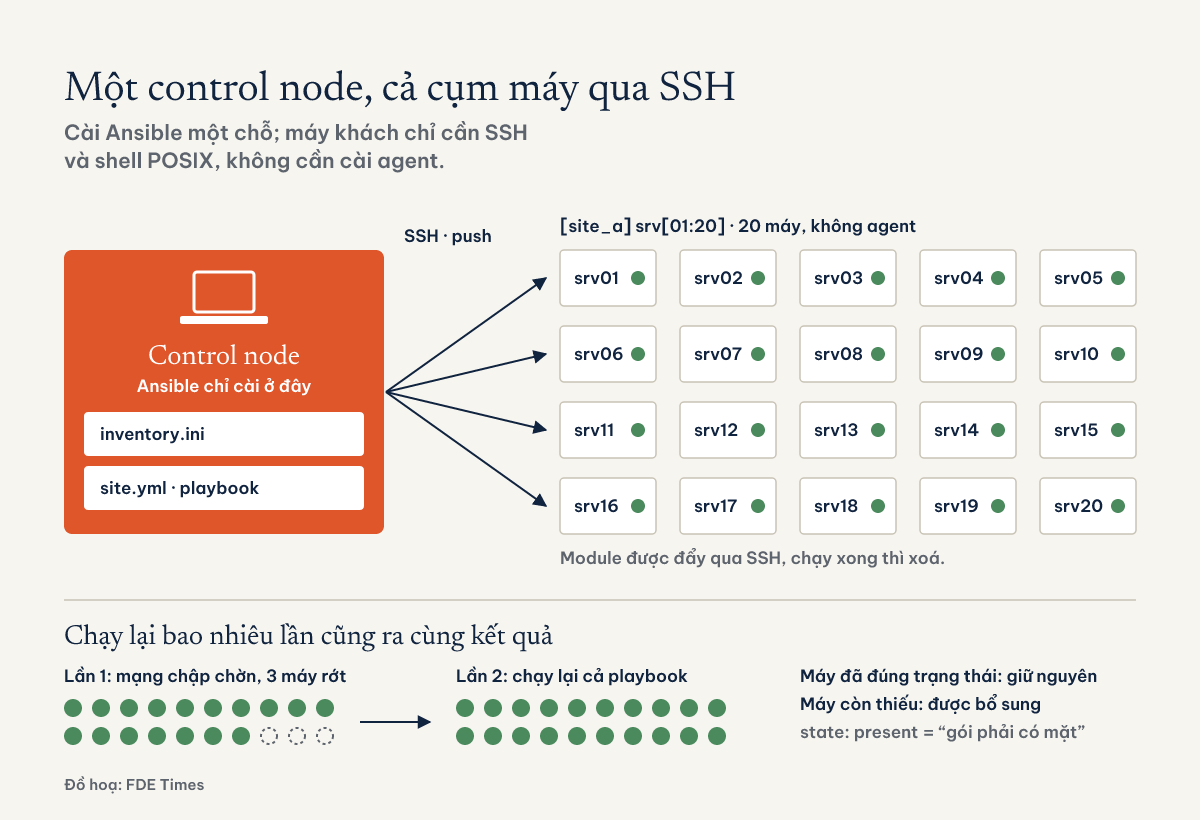
Một dòng inventory thay cho hai mươi dòng liệt kê máy, một playbook chạy lại bao nhiêu lần cũng ra cùng kết quả: khi phải động vào server của khách, FDE cần đúng hai thứ đó.
Ở site khách hàng, model tốt chưa đủ: bạn còn phải chỉ ra được bản nào đang chạy production, nó sinh ra từ đâu và bạn làm lại nó thế nào.
Chọn framework theo bản demo đẹp nhất thì dễ, nhưng FDE phải trả lời được câu hỏi khó hơn: sáu tháng nữa ai còn bảo trì nó, và đội bảo mật của khách có cho nó chạy không.
Tài liệu của Atlan hứa kết nối nguồn đầu tiên trong vài phút, nhưng việc khó của FDE bắt đầu sau đó: dữ liệu nào thuộc về ai, dữ liệu nào chạm vào thông tin cá nhân.
Khi người chấm câu trả lời của chatbot lại là một LLM khác, con số trên dashboard chỉ có giá trị nếu bạn biết phải kiểm tra nó ở đâu.
Cùng một engine có hai con số hiệu năng, "tới 24 lần" và "2-4 lần", vì mỗi con số so với một mốc khác nhau. FDE nào trích nhầm mốc trước đội hạ tầng của khách sẽ mất uy tín ngay buổi họp đầu.
Ở site khách hàng, câu hỏi nên hỏi trước tiên là đội vận hành của họ đang trực hệ thống nào lúc hai giờ sáng, chứ không phải engine nào chạy benchmark nhanh nhất.
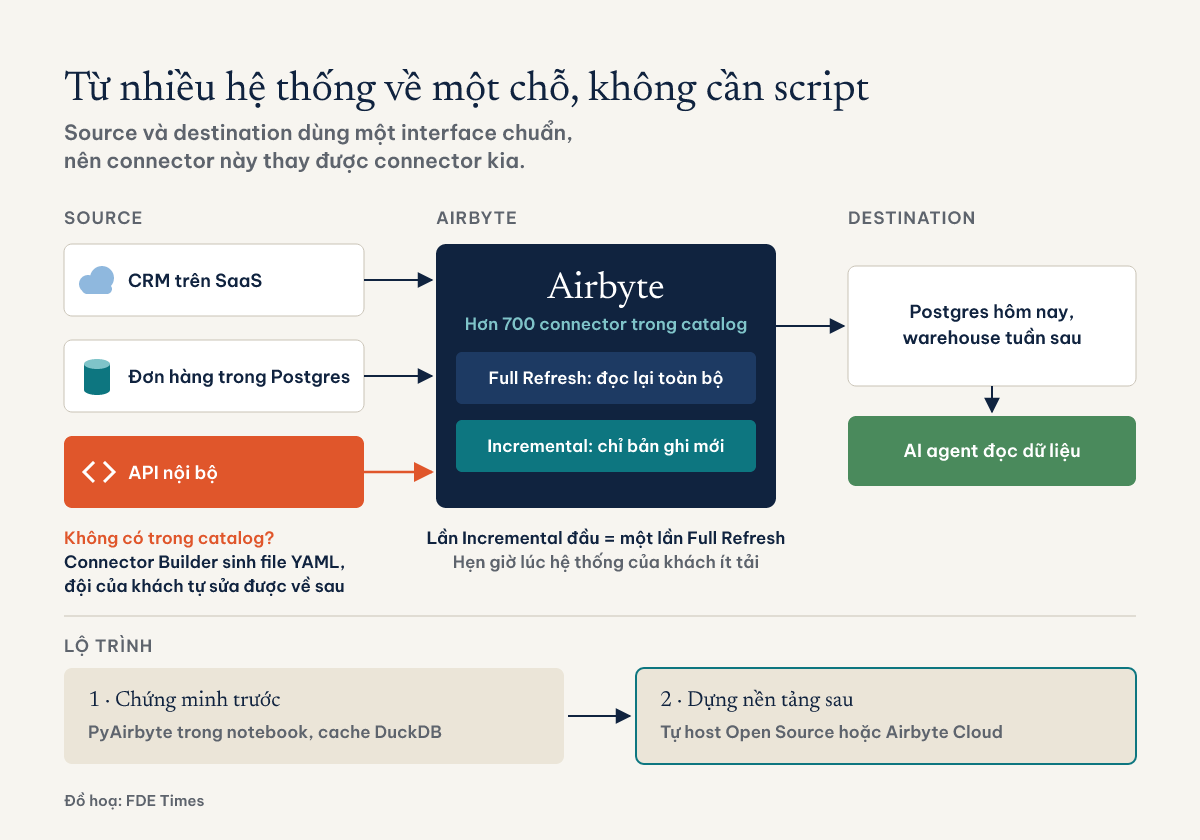
Tuần đầu ở chỗ khách, thứ ngốn thời gian của FDE thường là đi gom dữ liệu từ năm hệ thống khác nhau, còn model thì chưa kịp động tới; Airbyte được làm ra để bớt phần việc đó.
Ở công ty khách hàng, câu hỏi khó nhất thường không phải agent có làm được hay không, mà là ai bấm nút cho phép nó làm, và hàm interrupt của LangGraph được viết ra cho đúng khoảnh khắc đó.
HashiCorp khuyên viết module cho những gì bạn dựng đi dựng lại, nhưng cũng chính họ cảnh báo đừng dùng workspace để tách khách hàng — ranh giới đó quyết định bạn có ngủ ngon sau lần deployment thứ năm hay không.
Mỗi khách hàng chạy một provider khác nhau, nên FDE cần một lớp kiểm soát schema không phụ thuộc vào API của bất kỳ hãng nào, và cặp Pydantic cùng Instructor được dựng cho đúng việc đó.
Palantir gọi Foundry là hệ điều hành dữ liệu của doanh nghiệp, nhưng thứ một FDE thực sự phải học nằm ở tầng giữa: Ontology, bản sao số của cả tổ chức.
Phần lớn kỹ sư học Docker để chạy code trên laptop; FDE phải học lại nó như một công cụ giao hàng vào nơi không có internet, không có root và không cùng loại chip.
Giá trị của công cụ này với một FDE không nằm ở câu SELECT, mà ở thứ bạn để lại khi đã rời khỏi warehouse của khách.
Khách hàng sẽ hỏi "vì sao nó trả lời thế", "tốn bao nhiêu" và "có đang tốt lên không" — một công cụ mã nguồn mở đưa cả ba câu trả lời về cùng một nền tảng.
Giao thức Anthropic công bố cuối 2024 nay đã thuộc về Linux Foundation, và với FDE, nó biến bài toán tích hợp viết tay thành việc dựng một server có thể cắm vào Claude, ChatGPT, VS Code hay Cursor cùng lúc.
 Anthropic