Neural Networks: Zero to Hero: tám bài giảng của Andrej Karpathy, đi từ 150 dòng code đến GPT
Khi khách hàng hỏi vì sao mô hình trả lời sai, FDE từng tự tay viết backprop và tokenizer sẽ có câu trả lời mà người chỉ biết gọi API không có.
Tóm tắt nhanh
- Khoá học gồm 8 bài, mở đầu bằng micrograd (2h25m), qua 5 bài makemore, rồi GPT và GPT Tokenizer (2h13m); giáo trình vẫn được ghi là 'ongoing'.
- Bài 1 chỉ cần Python cơ bản và chút giải tích phổ thông, nhưng cả khoá đòi hỏi lập trình Python vững.
- Với FDE, giá trị lớn nhất của khoá là khả năng giải thích hành vi của mô hình cho khách hàng, chứ không phải tự đi train mô hình.
Bài đầu tiên của khoá học dài 2 giờ 25 phút, và thứ bạn có trong tay khi xem xong là một engine autograd khoảng 100 dòng, cộng một thư viện mạng nơ-ron khoảng 50 dòng. Đó là micrograd, điểm xuất phát của “Neural Networks: Zero to Hero”. Andrej Karpathy tự giới thiệu đây là khoá học dạy dựng mạng nơ-ron từ đầu, bằng code.
Khoá học không dạy cách gọi một mô hình có sẵn, mà dạy cách tự viết ra nó. Repo GitHub chính thức của khoá học mô tả nó là khoá học bắt đầu từ những kiến thức nền tảng nhất.
Với một developer muốn chuyển sang làm FDE, cách học này đáng thời gian bỏ ra. Thử hình dung khách hàng hỏi vì sao mô hình vừa làm một việc kỳ lạ. Kể cả khi bạn không bao giờ phải tự train mô hình, một lời giải thích đúng vẫn cần hiểu thứ nằm bên dưới API.
Tám bài giảng, học theo đúng thứ tự
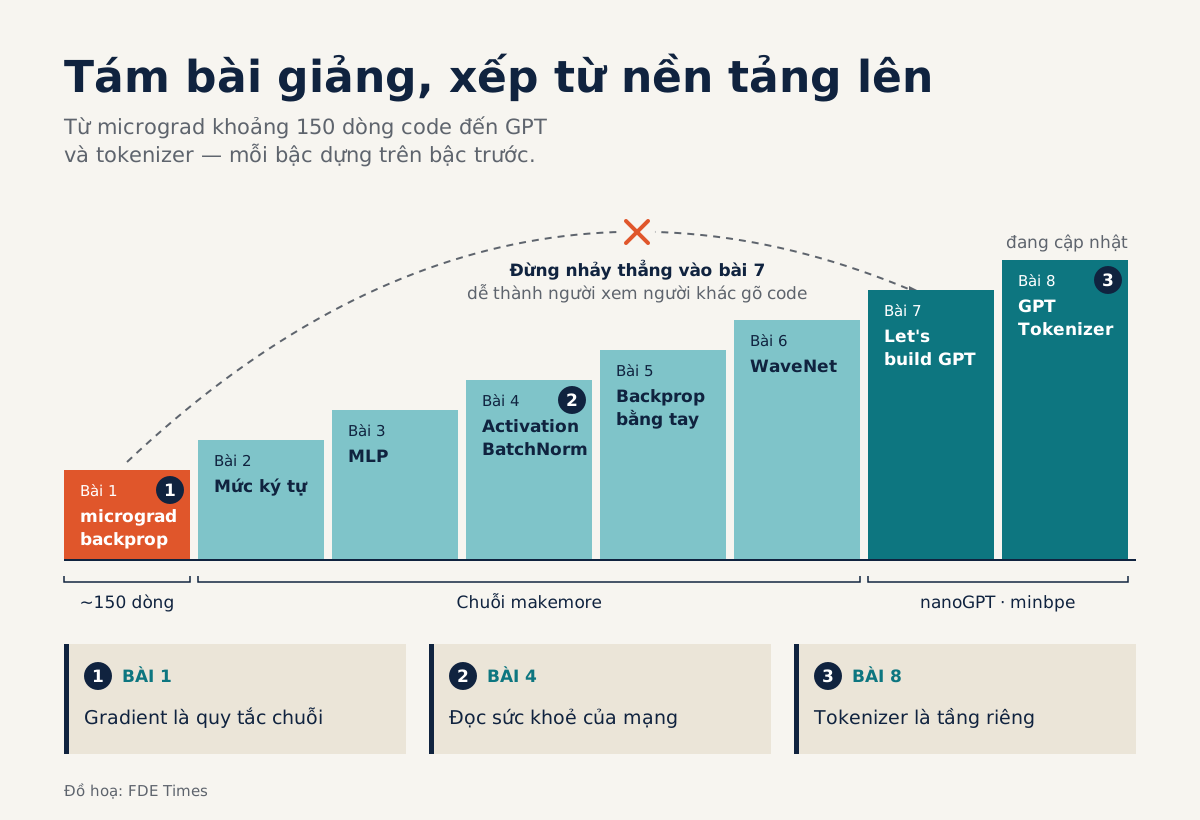
Trang chính thức trên karpathy.ai liệt kê giáo trình theo thứ tự rõ ràng. Bài 1 xây micrograd để giải thích backpropagation. Từ bài 2 đến bài 6 là chuỗi makemore: đi từ mô hình ngôn ngữ mức ký tự lên MLP, rồi tới activation, gradient và BatchNorm, tiếp đến tự viết backprop bằng tay, và kết thúc bằng WaveNet.
Bài 7, “Let’s build GPT”, là bài được biết đến nhiều nhất. Bài 8 dựng GPT Tokenizer và dài 2 giờ 13 phút. Giáo trình kết thúc bằng chữ “ongoing”, tức là có thể còn thêm bài mới.
Lời khuyên ở đây là đừng nhảy thẳng vào bài 7. Giáo trình được sắp từ nền tảng lên, nên đi tắt rất dễ biến bạn thành người ngồi xem người khác gõ code. Ngay cả repo nanoGPT, đi cùng chuỗi bài GPT, cũng khuyên người đọc xem Zero To Hero để hiểu bối cảnh về GPT và mô hình ngôn ngữ.
Ai nên học, và có cần giỏi toán không?
Hai nguồn chính thức nêu điều kiện đầu vào hơi khác nhau, và sự khác biệt đó có ích. Repo cho biết bài 1 chỉ cần Python cơ bản và còn nhớ đại khái giải tích hồi cấp ba. Trang chính thức thì yêu cầu cho cả khoá cao hơn: lập trình Python vững, và toán nhập môn như đạo hàm hay phân phối Gaussian.
Nếu bạn đã viết Python đi làm được hai, ba năm thì bạn đủ điều kiện. Phần toán, bạn có thể ôn lại khi cần. Thứ khó hơn là sự kiên nhẫn, vì đây là những video dài và đòi hỏi bạn gõ code theo từng bước.
Mỗi bài giảng đều có bài tập đi kèm, đặt trong phần mô tả video trên YouTube. Đừng bỏ qua chúng. Xem video mà không làm bài tập thì cũng giống như đọc tài liệu deployment mà chưa bao giờ deploy.
Ý thứ nhất: gradient chỉ là quy tắc chuỗi
Ý đầu tiên nên giữ lại đến từ micrograd. Hãy thử tự làm một ví dụ nhỏ: lấy f = a·b + c, với a = 2, b = -3, c = 10, ta có f = 4. Áp dụng quy tắc chuỗi thì đạo hàm của f theo a bằng b, tức là -3; theo b bằng a, tức là 2; và theo c bằng 1.
Toàn bộ backprop chỉ là làm phép tính đó ngược qua đồ thị, cho từng nút một. Khi đã tự tính tay được ba con số trên, bạn sẽ không còn coi training là phép màu nữa.
Ý thứ hai: học cách đọc sức khoẻ của mạng
Bài makemore phần 3, về activation, gradient và BatchNorm, dạy một thói quen rất gần với công việc của FDE: nhìn vào bên trong hệ thống để chẩn đoán, chứ không đoán mò. Trước khi kết luận một mô hình “học kém”, bạn cần kiểm tra xem tín hiệu có thực sự chảy qua các tầng hay không.
Thử một phép tính nhỏ với hàm tanh. Nếu đầu vào của một neuron là 5, đầu ra là tanh(5) ≈ 0,9999, và đạo hàm cục bộ 1 − tanh² chỉ còn khoảng 0,0002. Gradient đi ngược qua neuron đó bị nhân với con số gần bằng không, nên các trọng số phía trước gần như đứng yên dù loss vẫn cao.
Neuron ở trạng thái này gọi là bão hoà. Nếu nó bão hoà với mọi mẫu trong dữ liệu, nó gần như không bao giờ nhận được gradient đáng kể, và về thực chất đã “chết”. Cách phát hiện rất đơn giản: vẽ histogram đầu ra của từng tầng và đếm tỷ lệ giá trị có trị tuyệt đối lớn hơn 0,99.
Nếu phần lớn giá trị của một tầng dồn về hai đầu −1 và 1, nên nghi ngờ khởi tạo trọng số hoặc thang đo đầu vào trước khi nghi ngờ kiến trúc. BatchNorm là một cách kéo phân phối activation về lại vùng mà gradient còn chảy được.
Người mới thường mắc ba lỗi: chỉ nhìn đường loss mà không nhìn activation và gradient từng tầng; khởi tạo trọng số quá lớn khiến mạng bão hoà ngay từ bước đầu; và vội đổi kiến trúc hay tăng learning rate trước khi đo bất cứ thứ gì.
Ở chỗ khách hàng, thói quen này có thể áp dụng nguyên vẹn. Khi một pipeline cho kết quả tệ, việc đầu tiên nên làm là đo từng tầng một, trước khi bắt tay vào sửa prompt hay đổi mô hình.
Ý thứ ba: tokenizer là một tầng riêng
Bài 8 tách tokenizer ra thành một bài riêng, và mã nguồn của bài này được phát hành thành repo minbpe, kèm bản chữ của bài giảng trong file lecture.md. Điều đáng rút ra là mô hình không nhìn thấy chữ, mà chỉ thấy token, và cách chia token được quyết định ở một bước nằm ngoài mạng nơ-ron.
Thử hình dung một khách hàng ở Việt Nam hỏi vì sao prompt tiếng Việt tốn nhiều token hơn prompt tiếng Anh có cùng nội dung. Sau bài 8, bạn có thể mở tokenizer ra, cho khách xem văn bản bị chia thành những mảnh nào, và giải thích bằng chính dữ liệu của họ. Đó là kiểu câu trả lời giúp FDE lấy được lòng tin của khách hàng.
Biến khoá học thành bằng chứng trên CV
Câu “đã xem Zero to Hero” trên CV gần như không có giá trị gì. Thứ có giá trị là một repo nơi bạn tự viết lại micrograd, làm bài tập của các bài makemore, và viết README giải thích mỗi phần bằng lời của mình.
Khi đọc mô tả công việc FDE, hãy tìm những yêu cầu về hiểu cách mô hình hoạt động hay gỡ lỗi hành vi của mô hình: đó là chỗ nên đưa repo này ra.
Học xong tám bài, bước tiếp theo hợp lý là mở nanoGPT và minbpe, hai repo đi cùng khoá học, và tự đọc code thay vì chỉ xem video. Khi một khách hàng hỏi “tại sao”, bạn sẽ có câu trả lời, vì bạn đã từng tự viết ra chính thứ đang trả lời sai.