pgvector, Qdrant hay Elasticsearch: chọn vector database bắt đầu từ hệ thống khách đang chạy
Ở site khách hàng, câu hỏi nên hỏi trước tiên là đội vận hành của họ đang trực hệ thống nào lúc hai giờ sáng, chứ không phải engine nào chạy benchmark nhanh nhất.
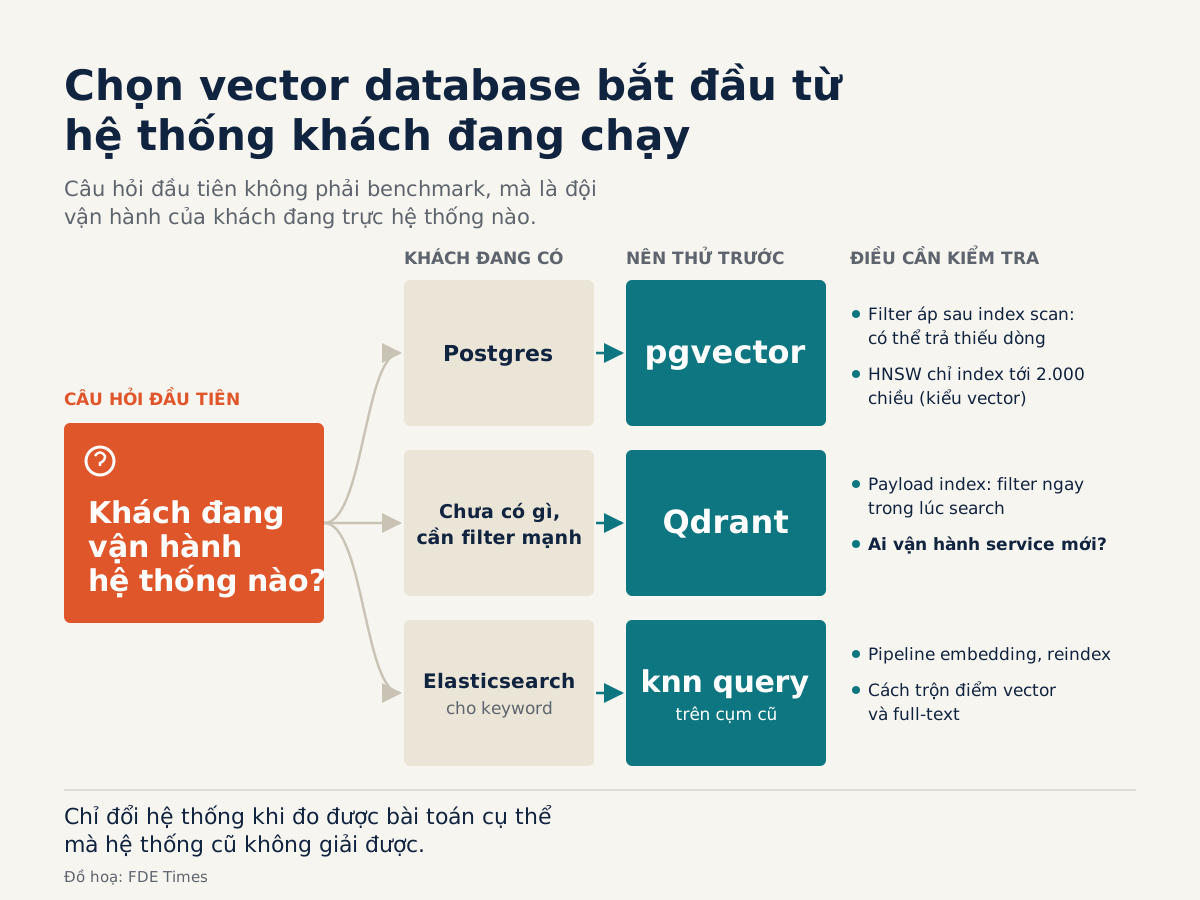
Tóm tắt nhanh
- Nếu khách đã chạy Postgres thì thử pgvector trước: vector nằm cạnh dữ liệu và được hưởng ACID, JOIN, point-in-time recovery.
- Khi dùng index approximate, pgvector chạy filter sau index scan nên có thể trả về ít kết quả hơn bạn yêu cầu. Qdrant có payload index để filter ngay trong lúc search.
- Nếu khách đã có Elasticsearch cho keyword search, dùng knn query trên cụm hiện có để làm hybrid search, nhưng vẫn phải lo pipeline embedding và cách trộn điểm.
Kỹ sư mới đến site khách hàng thường muốn so benchmark, đọc bảng xếp hạng rồi đề xuất một vector database “chuyên dụng”. Có một câu nên hỏi trước, và nó đơn giản hơn nhiều: khách đang vận hành hệ thống nào? Câu trả lời thường quyết định được gần hết lựa chọn.
Lý do rất thực tế. Mỗi service mới kéo theo backup, giám sát, phân quyền và một người phải trực khi nó sập. Với FDE, chọn vector database chủ yếu là bài toán đi vào hạ tầng có sẵn của khách, còn hiệu năng thuần chỉ là một phần. Dưới đây là ba lựa chọn phổ biến và lúc nào nên dùng cái nào.
Khách đã chạy Postgres? Thử pgvector trước
Repository chính thức mô tả pgvector là phần mở rộng mã nguồn mở để tìm kiếm vector tương đồng cho Postgres. Lợi ích lớn nhất nằm ở vị trí của nó. Vector được lưu ngay cạnh dữ liệu nghiệp vụ, nên được hưởng luôn ACID, point-in-time recovery và JOIN như README liệt kê.
Thử hình dung một công ty bảo hiểm có bảng hợp đồng trong Postgres. Bạn thêm một cột embedding vào bảng điều khoản. Từ đó một truy vấn có thể vừa tìm đoạn văn gần nghĩa nhất, vừa JOIN sang bảng khách hàng để lấy tên và trạng thái hợp đồng.
Bạn không cần pipeline đồng bộ giữa hai hệ thống, nên cũng không có chuyện dữ liệu ở hai nơi lệch nhau.
Có một chi tiết nên biết: pgvector mặc định tìm kiếm chính xác (exact nearest neighbor), và README nói rõ cách này cho recall hoàn hảo. Index approximate chỉ có khi bạn chủ động tạo, gồm hai loại. HNSW dựng một đồ thị nhiều tầng, còn IVFFlat chia dữ liệu thành các list.
HNSW cân bằng tốc độ và recall tốt hơn, đổi lại tốn nhiều thời gian build và bộ nhớ hơn.
Vì vậy, quy trình hợp lý là chạy exact search trước để có “đáp án chuẩn”. Sau đó mới tạo HNSW và đo xem top 10 của hai cách còn trùng nhau bao nhiêu kết quả. Con số đó cho biết bạn đã đổi bao nhiêu recall để lấy tốc độ, và bạn có thể đưa nó cho khách xem.
Hai cái bẫy có thể làm hỏng buổi demo
Cái bẫy đầu tiên là filter. Với index approximate, pgvector áp filter sau khi đã quét index. Hệ quả là truy vấn có thể trả về ít kết quả hơn bạn nghĩ.
Thử hình dung một hệ thống multi-tenant. Bạn hỏi top 10 tài liệu gần nhất thuộc về một khách hàng nhỏ. Index HNSW lấy ra một nhóm ứng viên gần nhất trên toàn bộ dữ liệu, rồi mới lọc theo tenant. Nếu trong nhóm đó chỉ có 3 tài liệu của tenant này, người dùng nhận về 3 dòng thay vì 10.
Người dùng sẽ kết luận chatbot “không tìm thấy gì”, trong khi tài liệu vẫn nằm trong database.
Cái bẫy thứ hai là số chiều. pgvector lưu được vector tới 16.000 chiều, nhưng HNSW chặt hơn nhiều: với kiểu vector, nó chỉ index được tới 2.000 chiều. Nếu embedding model của khách cho ra vector dài hơn mức đó, bạn vẫn lưu được nhưng không dựng được HNSW trên kiểu vector.
Hãy kiểm tra con số này ngay khi chọn model, đừng đợi đến ngày load dữ liệu thật mới phát hiện.
Khi nào Qdrant đáng để thêm một service mới
Qdrant hoạt động theo mô hình client-server, có API qua HTTP và gRPC nên gọi được từ gần như mọi ngôn ngữ. Đơn vị dữ liệu là point, gồm một vector và một payload metadata không bắt buộc.
Trong bài toán multi-tenant ở trên, thứ làm Qdrant khác pgvector là payload index. Bạn tạo index trên các trường cụ thể như tenant_id, và filter được áp dụng ngay trong lúc search. Qdrant không đợi tìm xong rồi mới lọc như index approximate của pgvector. Qdrant cũng hỗ trợ hybrid retrieval, kết hợp dense vector để tìm theo nghĩa với sparse vector để tìm theo từ khóa.
Vì thế, Qdrant đáng cân nhắc khi filter là yêu cầu chính của hệ thống, chẳng hạn multi-tenant với rất nhiều tenant nhỏ, và khách sẵn sàng vận hành thêm một service. Nếu không có ai trực service đó, lợi thế kỹ thuật sẽ biến thành gánh nặng vận hành.
Khách đã có Elasticsearch: tận dụng cụm hiện có
Nếu khách đang chạy Elasticsearch cho keyword search, tài liệu của Elastic cho thấy dense vector được truy vấn bằng knn query. Nghĩa là bạn có thể thêm vector search vào chính cụm đang chạy. Elastic cũng giới thiệu cách kết hợp vector với full-text search để làm hybrid search.
Thử hình dung một nhà phân phối thiết bị lưu tài liệu kỹ thuật trên Elasticsearch. Kỹ thuật viên gõ: “máy bơm PX-220 kêu to khi khởi động”. Mã PX-220 là thứ full-text search bắt chính xác, còn vế “kêu to khi khởi động” cần tìm theo nghĩa vì tài liệu có thể ghi là “tiếng ồn bất thường”.
Nếu chỉ dùng vector, kết quả có thể trôi sang một mẫu máy bơm khác có mô tả tương tự. Nếu chỉ dùng keyword, hệ thống bỏ sót những đoạn viết bằng từ khác. Hybrid search giải được cả hai vế, nhưng chỉ khi điểm của hai bên được trộn đúng.
Đừng nghĩ việc này chỉ là thêm một trường. Bạn vẫn cần pipeline sinh embedding cho cả tài liệu cũ lẫn tài liệu mới, có thể phải reindex dữ liệu hiện có, và phải chọn cách trộn điểm vector với điểm full-text. Lợi thế nằm ở chỗ khác: cụm đã có index, phân quyền và người vận hành, nên rủi ro thấp hơn so với dựng hệ thống mới.
Việc nên làm đầu tiên là gom khoảng 20 câu hỏi thật vừa có mã sản phẩm vừa có mô tả tự nhiên. Chạy riêng full-text, riêng knn rồi chạy hybrid, sau đó xem cách nào đưa đúng tài liệu lên đầu.
| Khách đang có | Nên thử trước | Điều cần kiểm tra |
|---|---|---|
| Postgres | pgvector | Filter sau index scan, giới hạn 2.000 chiều của HNSW |
| Chưa có gì, cần filter mạnh | Qdrant | Ai vận hành service mới |
| Elasticsearch cho keyword | knn query trên cụm cũ | Pipeline embedding, reindex, cách trộn điểm vector và full-text |
Nên học gì trước
Nếu chỉ có một tuần, hãy học pgvector, vì rất nhiều khách hàng dùng Postgres. Tập trung vào ba việc: so exact search với HNSW, tái hiện lỗi filter trả thiếu kết quả, và đọc kỹ giới hạn số chiều. Sau đó dựng thử Qdrant với payload index để thấy cùng bài toán filter được giải theo cách khác.
Khi đọc JD các vị trí FDE, hãy để ý những cụm như “integrate with existing data infrastructure” hay “RAG in production”. Trong CV, câu “dùng vector database X” không nói lên nhiều.
Một câu như “đo recall giữa exact search và HNSW, phát hiện và sửa lỗi filter trả thiếu kết quả trong hệ thống multi-tenant” cho nhà tuyển dụng thấy bạn từng làm việc với dữ liệu thật.
Vector database tốt nhất cho một dự án thường là hệ thống mà khách đã biết cách giữ cho nó chạy. Chỉ chuyển sang thứ khác khi bạn đo được một bài toán cụ thể mà hệ thống cũ không giải được.