Sửa retrieval trước, sửa prompt sau: bài học từ khoá RAG của Jason Liu
Khoá học của Jason Liu trên Maven dạy một kỷ luật mà FDE nào cũng cần khi demo đã xong và khách hàng hỏi vì sao chatbot vẫn trả lời sai.

Tóm tắt nhanh
- Khoá học của Jason Liu trên Maven dạy cải tiến RAG bằng số đo, không dựa vào việc demo trông có vẻ ổn.
- Theo Liu, lỗi phổ biến nhất là lo tối ưu phần sinh câu trả lời trong khi phần tìm kiếm còn chưa ổn.
- Nên đọc bài RAG Playbook miễn phí và nghe tập 709 của TWIML trước khi quyết định đăng ký.
“Đừng xây những hệ RAG gây ấn tượng lúc demo rồi làm thất vọng khi lên production.” Đó là câu mở đầu trang giới thiệu khoá Systematically Improving RAG Applications của Jason Liu trên Maven, thuộc dòng sản phẩm Applied LLMs. Một câu marketing, nhưng nó gọi đúng tên khoảnh khắc mà FDE nào cũng từng trải qua.
Bạn dựng xong chatbot hỏi đáp trên tài liệu nội bộ của khách hàng. Buổi demo trôi chảy. Hai tuần sau, người dùng thật bắt đầu phàn nàn rằng câu trả lời sai, thiếu, hoặc trích nhầm tài liệu.
Lúc đó câu hỏi không còn là “làm sao cho hay hơn” mà là “sai ở đâu, sửa cái gì trước”. Khoá học này dạy cách trả lời câu hỏi thứ hai bằng con số.
Ai dạy, và vì sao điều đó quan trọng?
Liu tự giới thiệu là staff ML engineer kiêm tư vấn AI, đã xây hệ thống search và recommendation trong 8 năm, và là người tạo ra thư viện Instructor. Lý lịch đó giải thích góc nhìn của khoá học: RAG trước hết là một bài toán search, rồi mới đến bài toán LLM.
Trong bài viết miễn phí The RAG Playbook trên blog jxnl.co, Liu chỉ ra lỗi mà khoá học nhắm vào: các nhóm mải mê tối ưu phần sinh câu trả lời trong khi phần tìm kiếm còn chưa ổn.
Họ sửa prompt, đổi model, thêm hướng dẫn, trong khi đoạn tài liệu chứa đáp án chưa bao giờ được đưa vào context. Không prompt nào cứu được một retriever trả về sai tài liệu.
Khoá học dạy những gì?
Theo trang chính thức, nội dung xoay quanh ba mảng. Đầu tiên là đo chất lượng retrieval bằng các chỉ số IR chuẩn (precision, recall, MRR) để tìm điểm yếu.
Tiếp theo là dựng pipeline dữ liệu tổng hợp và bộ đánh giá: dùng LLM sinh các cặp câu hỏi và câu trả lời sát thực tế, rồi lập baseline với những công cụ như LanceDB.
Cuối cùng là kiến trúc: hybrid search kết hợp BM25, embedding và metadata, cùng query routing.
Trang khoá học cũng nêu các mức cải thiện cụ thể, như tăng 20% độ chính xác nhờ re-ranking và 14% nhờ cross-encoder. Hãy coi đó là con số do người bán tự công bố, chưa được kiểm chứng độc lập.
Con số hơn 400 kỹ sư đã học cũng là số tự báo cáo. Cohort trên trang diễn ra từ 17 đến 30 tháng 11, còn năm thì trang không ghi rõ.
Ba ý đáng giữ lại
Một: đo retrieval tách riêng khỏi generation. Thử hình dung một câu hỏi có 3 đoạn tài liệu liên quan. Retriever trả về top-5, trong đó có 2 đoạn đúng ở vị trí thứ 2 và thứ 4.
Recall@5 là 2/3, khoảng 67%. Precision@5 là 2/5, tức 40%. Reciprocal rank là 1/2 vì đoạn đúng đầu tiên nằm ở vị trí 2, và MRR là trung bình của giá trị này trên cả bộ câu hỏi.
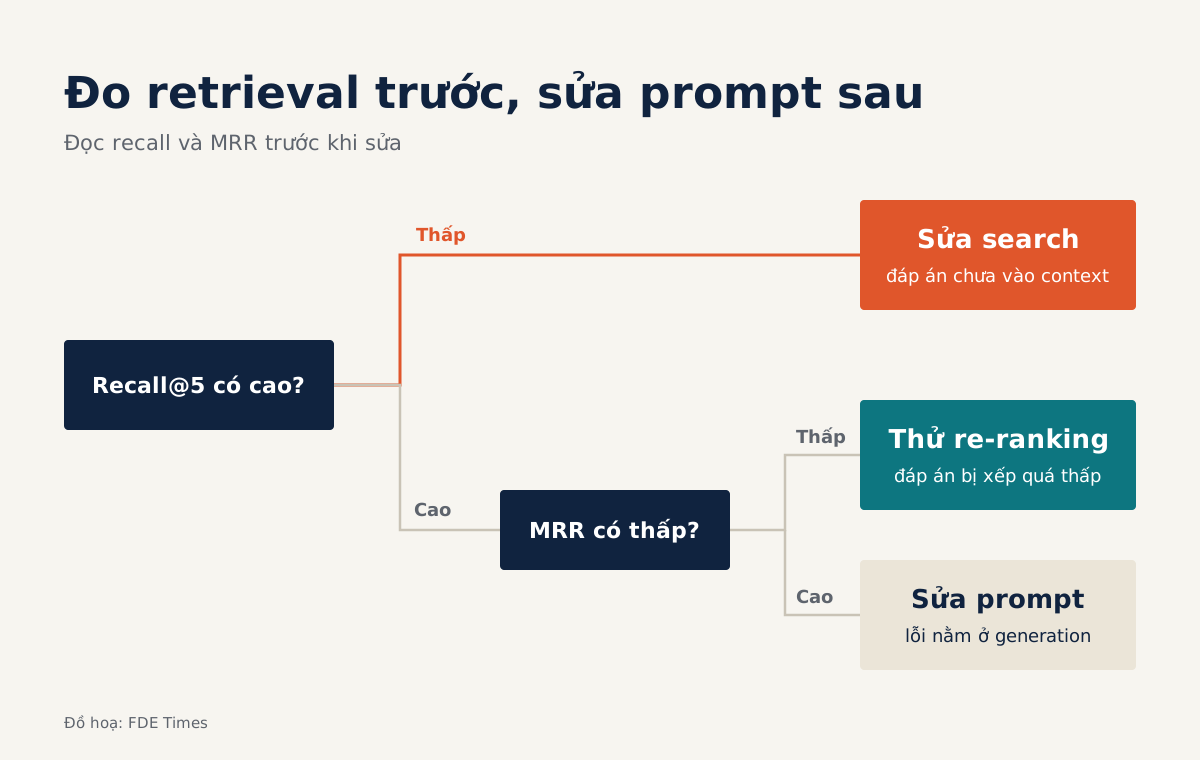
Ba con số đó kể ba chuyện khác nhau. Recall thấp nghĩa là đáp án không vào được context, nên việc cần làm là sửa search. Recall cao nhưng câu trả lời vẫn sai thì lỗi mới nằm ở phần generation. Có số đo rồi, bạn biết nên mở file nào trước.
Hai: đừng chờ người dùng thật. Liu gọi dữ liệu tổng hợp là “vũ khí bí mật”. Cho LLM đọc từng đoạn tài liệu, sinh một câu hỏi mà đoạn đó trả lời được, rồi kiểm tra xem retriever có tìm lại được đúng đoạn đó không. Chỉ trong một buổi chiều, bạn có baseline precision và recall trước cả khi khách hàng mở hệ thống cho nhân viên dùng.
Với FDE, đây là lợi thế thật sự. Bạn thường phải chứng minh tiến độ trong vài tuần đầu, khi chưa có log truy vấn nào. Một bảng baseline kèm kết quả sau mỗi lần thay đổi thuyết phục khách hàng hơn mọi câu “giờ trông ổn hơn rồi”.
Ba: số đo thay cho phỏng đoán, rồi dần thành trực giác. Liu lập luận rằng chỉ số rõ ràng giúp bạn hình thành trực giác về những gì thật sự tạo ra khác biệt. Khi đã thấy hybrid search kéo recall lên với loại câu hỏi chứa mã sản phẩm, lần sau gặp khách hàng có dữ liệu tương tự, bạn sẽ thử nó trước tiên.
Muốn nắm chắc cả ba ý, hãy tự làm một bài tập nhỏ. Giả sử bạn có 5 câu hỏi, mỗi câu có đúng một đoạn tài liệu đúng; retriever đặt đoạn đúng ở vị trí 1, 3, 2 và 5 cho bốn câu đầu, còn câu thứ năm thì không thấy trong top-5.
Recall@5 là 4/5, tức 80%. Reciprocal rank lần lượt là 1, 1/3, 1/2, 1/5 và 0; cộng lại được khoảng 2,03, chia cho 5 ra MRR khoảng 0,41.
Đọc hai con số cùng nhau: retriever gần như luôn tìm thấy đáp án, nhưng thường xếp nó quá thấp. Đó là tín hiệu để thử re-ranking trước khi động vào prompt.
Ai nên học, và bắt đầu từ đâu?
Khoá học hợp nhất với kỹ sư đã từng đưa ít nhất một hệ RAG đến tay người dùng và đang kẹt ở giai đoạn “lúc đúng lúc sai”.
Nếu chưa có hệ thống nào, bạn vẫn có thể bắt đầu, vì dữ liệu tổng hợp cho phép thử nghiệm mà không cần chờ người dùng. Dù vậy, lời khuyên ở đây là tự dựng một dự án RAG nhỏ trước, để các chỉ số có chỗ bám vào.
Trước khi đăng ký, hãy đọc The RAG Playbook trên jxnl.co rồi nghe tập 709 của TWIML AI Podcast (tháng 11 năm 2024), nơi Liu bàn về bộ dữ liệu kiểm thử, thử nghiệm dựa trên dữ liệu và chỉ số cho từng loại use case. Nếu hai nguồn miễn phí này chạm đúng vấn đề bạn đang gặp, khoá học trên Maven là bước tiếp theo.
Về sự nghiệp, kỹ năng này dễ chứng minh hơn bạn nghĩ. Trong CV, thay vì ghi “xây chatbot RAG”, hãy ghi bạn đã dựng bộ đánh giá bao nhiêu câu hỏi và recall thay đổi ra sao sau khi đổi chiến lược search.
Khi đọc JD FDE có nhắc đến RAG hay LLM, hãy hỏi trong buổi phỏng vấn rằng nhóm đang đo chất lượng retrieval thế nào. Câu trả lời cho bạn biết mình sẽ bước vào một dự án có kỷ luật đo lường hay một dự án còn chạy theo cảm giác, và câu hỏi đó cũng cho người phỏng vấn thấy bạn nghĩ như người đã làm thật.
Demo chỉ cho thấy hệ thống có chạy được hay không. Còn khách hàng có tiếp tục dùng sau khi demo kết thúc hay không thì phụ thuộc vào việc bạn đo được mình đang làm tốt đến đâu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!