Databricks tuyển FDE bằng Spark, còn Unity Catalog và Genie nằm ngoài danh sách yêu cầu
Tin tuyển ghi rõ yêu cầu Spark, nhưng tài liệu sản phẩm cho thấy Genie chỉ trả lời đúng khi quyền truy cập, row filter và quy tắc nghiệp vụ được làm kỹ.
Tóm tắt nhanh
- Tin FDE của Databricks ở Seoul đòi 7+ năm kinh nghiệm và hiểu sâu Spark, kể cả runtime internals.
- Unity Catalog lo quyền truy cập, lineage và audit; Genie trả lời dựa trên đúng những quyền đó.
- Thứ tự học hợp lý: Spark và Spark UI, rồi SQL governance của Unity Catalog, cuối cùng là cấu hình Genie Agent.
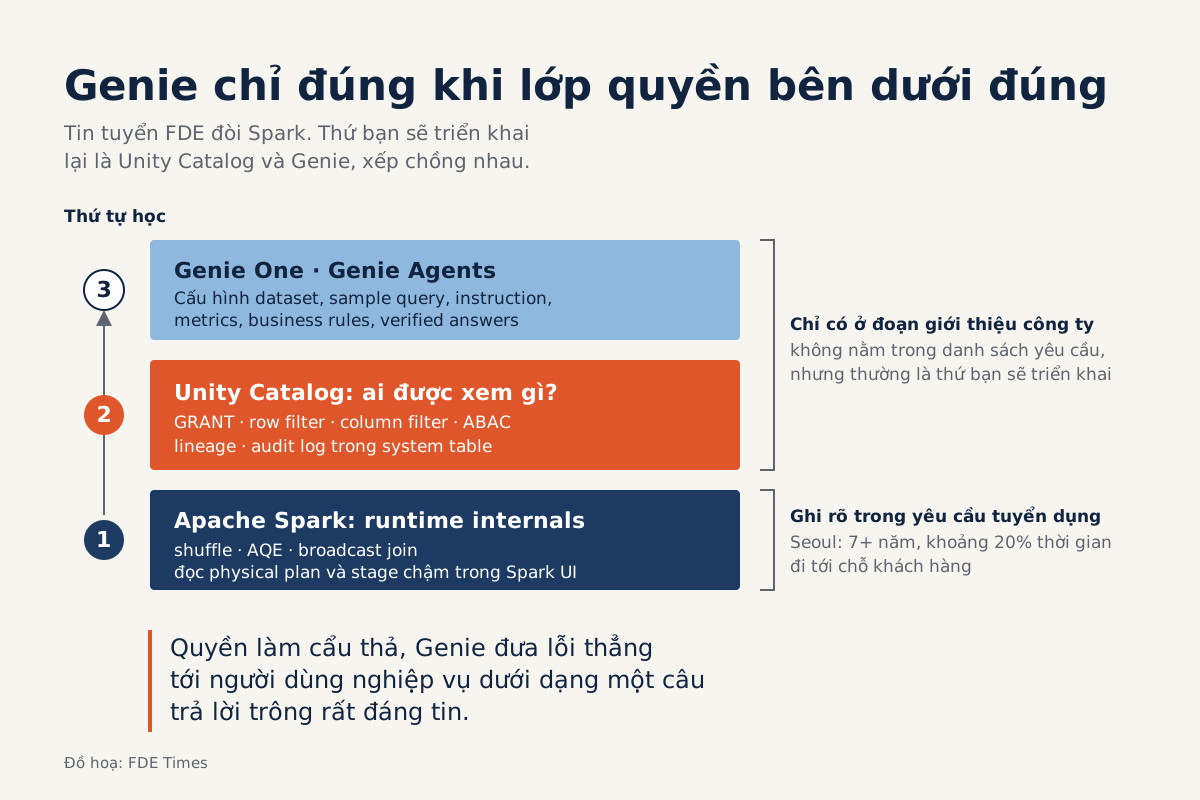
Tin tuyển Forward Deployed Engineer của Databricks tại Seoul ghi rõ ứng viên phải có kinh nghiệm sâu về tính toán phân tán với Apache Spark và hiểu cả runtime internals của Spark. Genie và Unity Catalog lại chỉ có mặt trong đoạn giới thiệu công ty, không nằm trong danh sách yêu cầu.
Spark là thứ phải chuẩn bị để qua vòng tuyển. Còn theo tài liệu chính thức, triển khai Unity Catalog và Genie là chuyện quyền truy cập, metadata và quy tắc nghiệp vụ.
Spark: học đến mức giải thích được một job chậm
Tin ở Seoul đòi 7+ năm trong data engineering, nền tảng dữ liệu và analytics hoặc software engineering, biết code Python, Scala hoặc JavaScript/TypeScript, và dành khoảng 20% thời gian đi tới chỗ khách hàng. Tin Senior FDE mảng National Security giữ nguyên câu yêu cầu Spark, hạ xuống 6+ năm và thêm hiểu biết thực tế về MLOps, mô hình ML/AI và AI API.
“Runtime internals” nghe mơ hồ, nhưng có thể quy về ba thứ cụ thể. Thứ nhất là shuffle: join và aggregation buộc dữ liệu đổi chỗ giữa các node, và spark.sql.shuffle.partitions mặc định chia việc đó thành 200 partition.
Thứ hai là Adaptive Query Execution, bật mặc định từ Spark 3.2.0. AQE dùng thống kê lúc chạy để gộp các partition sau shuffle quá nhỏ và tách partition bị skew trong sort-merge join. Thứ ba là broadcast join: bảng nhỏ hơn spark.sql.autoBroadcastJoinThreshold, mặc định 10 MB, được gửi tới mọi worker thay vì phải shuffle.
Cách luyện là tự làm chậm một job rồi đọc Spark UI. Join một bảng lớn với một bảng nhỏ, mở tab SQL, bấm Details để xem physical plan dùng BroadcastHashJoin hay SortMergeJoin. Tắt broadcast bằng cách đặt ngưỡng về -1, chạy lại và so thời gian.
Sau đó mở trang chi tiết của stage chậm nhất. Bảng Summary Metrics cho thấy phân bố thời gian chạy của các task: nếu task chậm nhất lâu gấp nhiều lần trung vị, nhiều khả năng dữ liệu bị skew. Cột Shuffle Read Size và Shuffle spill (disk) cho biết dữ liệu đổi chỗ bao nhiêu và có tràn xuống đĩa hay không.
Hãy tập kể lại những gì vừa thấy bằng chính con số trên UI. Trong phỏng vấn, đó là cách cụ thể nhất để cho thấy bạn hiểu Spark chạy thế nào bên dưới.
Unity Catalog trả lời câu “ai được xem gì?”
Databricks định nghĩa Unity Catalog là lớp governance thống nhất cho dữ liệu và AI, có sẵn trong nền tảng. Mọi đối tượng nằm trong không gian tên ba cấp catalog.schema.object. Bảng và volume có thể là managed, tức Unity Catalog lo cả governance lẫn vòng đời file lưu trữ bên dưới, hoặc là external.
Theo Microsoft Learn, mọi workspace Azure Databricks tạo sau ngày 9/11/2023 đều tự động bật Unity Catalog, và Unity Catalog cũng có bản open source. Vậy nên ở khách hàng dùng workspace mới, nhiều khả năng bạn sẽ làm việc với nó ngay từ đầu.
Tài liệu chia khả năng của Unity Catalog thành nhiều mảng, trong đó ba mảng nên học trước là phân quyền, lineage và audit. Phân quyền đi qua privileges, chính sách theo thuộc tính (ABAC), row filter, column filter và workspace binding.
Lineage ghi lại đường đi từ dữ liệu nguồn tới model, service và dashboard mà không cần cấu hình tay, còn mọi lượt truy cập dữ liệu và hoạt động hệ thống nằm trong một system table dành cho audit log, thứ bộ phận compliance sẽ cần tới.
Ví dụ: mỗi chi nhánh chỉ thấy dữ liệu của mình
Thử hình dung một chuỗi bán lẻ có bảng sales.core.orders với cột region. Yêu cầu đặt ra: nhóm analyst ở Việt Nam chỉ được thấy đơn hàng của Việt Nam, còn nhóm admin thấy toàn bộ. Bước đầu tiên là cấp quyền đọc:
GRANT USE CATALOG ON CATALOG sales TO `analysts_vn`;
GRANT USE SCHEMA ON SCHEMA sales.core TO `analysts_vn`;
GRANT SELECT ON TABLE sales.core.orders TO `analysts_vn`;
Chỉ có GRANT SELECT thì nhóm này vẫn đọc được mọi dòng. Muốn giới hạn theo vùng, bạn viết một hàm trả về true hoặc false cho từng dòng, rồi gắn hàm đó vào bảng:
CREATE FUNCTION sales.gov.region_filter(region STRING)
RETURN IF(is_account_group_member('admins'), true, region = 'VN');

ALTER TABLE sales.core.orders
SET ROW FILTER sales.gov.region_filter ON (region);
Từ đây, cùng một câu SELECT * FROM sales.core.orders sẽ trả về hai kết quả khác nhau tùy người chạy. Logic phân quyền nằm ở bảng chứ không nằm rải rác trong từng dashboard. Ở khách hàng, hãy ngồi với chủ dữ liệu để chốt bảng “ai thấy dòng nào” trước, sau đó mới viết hàm.
Hai chi tiết đáng nhớ từ tài liệu. Kiểu tham số của hàm phải khớp kiểu cột: nếu lệch và ANSI mode đang tắt, giá trị không ép kiểu được sẽ thành NULL và bộ lọc có thể trả về toàn bộ bảng mà không báo lỗi.
Ngoài ra, khi cần cùng một quy tắc trên nhiều bảng, Databricks khuyên dùng ABAC policy gắn ở cấp catalog hoặc schema thay vì gắn row filter từng bảng.
Genie đứng trên Unity Catalog, nên quyền sai thì câu trả lời cũng sai
Theo tài liệu tháng 9/2026, Genie giờ là một họ sản phẩm gồm Genie One, Genie Agents và Genie Code. Genie Agents là môi trường theo từng mảng nghiệp vụ, nơi đội dữ liệu cấu hình dữ liệu tin cậy, metrics và quy tắc nghiệp vụ để Genie One dựa vào đó trả lời.
Tên gọi cũng đã đổi: trang tổng quan hiện tại không còn dùng thuật ngữ “Genie space”. Khi đọc tutorial cũ, hãy kiểm tra ngày cập nhật trước khi làm theo.
Databricks khẳng định mọi câu trả lời của Genie đều dựa trên dữ liệu của tổ chức và đi qua lớp governance của Unity Catalog.
Hệ quả rất thực tế: row filter ở ví dụ trên cũng sẽ quyết định người dùng Genie ở Việt Nam thấy những gì. Nếu bộ quyền làm cẩu thả, Genie sẽ đưa lỗi đó thẳng tới người dùng nghiệp vụ dưới dạng một câu trả lời trông rất đáng tin.
Dựng một Genie Agent là việc cấu hình: chọn dataset, viết sample query, viết instruction. Sau đó chất lượng được tinh chỉnh bằng metrics, business rules và verified answers. Chẳng hạn, nếu khách định nghĩa “doanh thu thuần” là đã trừ hàng trả lại, đó phải là một business rule, và câu hỏi được hỏi nhiều nhất trong tuần nên có một verified answer.
Theo tài liệu, người dùng được dùng Genie One và Genie Agents miễn phí đến hết ngày 31/1/2027; service principal không nằm trong diện miễn phí. Đây là lúc thuận tiện để luyện tay.
Học gì trước, và ghi gì vào CV
Thứ tự hợp lý là Spark và Spark UI trước, vì đó là cửa vào. Tiếp theo là SQL governance của Unity Catalog: GRANT, row filter, column filter, đọc lineage và audit log. Genie Agent học sau cùng, vì nó dựa trên hai lớp kia.
Trong CV, thay vì ghi “biết Databricks”, hãy mô tả việc cụ thể: “tìm ra skew trong một join bằng Spark UI, giảm thời gian job từ X xuống Y”, hoặc “thiết kế row filter theo vùng cho bảng đơn hàng, kiểm chứng bằng audit log”.
Khi đọc JD, đừng bỏ qua những sản phẩm chỉ xuất hiện ở đoạn giới thiệu công ty. Chúng thường là thứ bạn sẽ triển khai, và với Genie, chất lượng câu trả lời phụ thuộc vào lớp quyền bên dưới.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
10 nguồn
- What is Unity Catalog? | Databricks on AWS · 2026-09-11
- What is Unity Catalog? - Azure Databricks | Microsoft Learn · 2026-09-11
- Genie - Azure Databricks | Microsoft Learn · 2026-09-18
- Genie | Databricks on AWS · 2026-09-18
- Forward Deployed Engineer - Databricks
- Sr. Forward Deployed Engineer - National Security
- Performance Tuning - Spark SQL documentation
- Web UI - Spark documentation
- Row filters and column masks - Azure Databricks | Microsoft Learn · 2026-10-08
- Manually apply row filters and column masks - Azure Databricks | Microsoft Learn · 2026-10-08