Khi dữ liệu của khách là một mạng: Neo4j, Neptune và GraphRAG
Khi câu SQL của bạn phải JOIN hết lớp này đến lớp khác chỉ để lần theo một vòng gian lận, có lẽ vấn đề nằm ở mô hình dữ liệu chứ không ở câu truy vấn.
Tóm tắt nhanh
- Graph database đáng dùng khi câu hỏi đi theo quan hệ nhiều bước; dữ liệu dạng bảng đơn giản vẫn hợp với relational DB hơn.
- Neo4j xoay quanh Cypher; Neptune hỗ trợ cả Gremlin, openCypher lẫn SPARQL, có một writer và tối đa 15 read replica.
- GraphRAG nhắm vào loại câu hỏi bao quát cả kho tài liệu, nơi RAG thông thường bị hụt.
Bạn đang ở tuần thứ hai tại một công ty fintech. Đội risk đưa bạn ba bảng: tài khoản, thẻ thanh toán, địa chỉ IP đăng nhập. Câu hỏi của họ nghe đơn giản: “Những tài khoản nào dùng chung thẻ, email hoặc IP với một tài khoản đã bị xác nhận gian lận, kể cả gián tiếp qua hai, ba lớp?”
Bạn mở Postgres, viết câu đầu tiên, rồi câu thứ hai dài gấp đôi. Đến lớp thứ ba, truy vấn có hàng loạt JOIN, chạy chậm, và không ai trong phòng dám chắc nó đúng.
Đây là khoảnh khắc mà một FDE cần nhận ra sớm: dữ liệu của khách không phải là một tập bảng, mà là một mạng. Nhận ra sớm thì bạn chọn đúng công cụ trong tuần đầu, thay vì phải viết lại cả pipeline vào tháng thứ hai.
Khi nào dữ liệu thật sự là một mạng?
AWS định nghĩa graph database là loại cơ sở dữ liệu lưu dữ liệu như một mạng các thực thể và quan hệ giữa chúng. Ngay trong tài liệu đó, AWS cũng nói rõ graph database chuyên dụng mang lại nhiều giá trị nhất cho các tập dữ liệu có mức kết nối cao, còn dữ liệu dạng bảng đơn giản thì hợp với relational database hơn.
Câu sau quan trọng ngang câu trước. Danh sách đơn hàng, bảng lương, log giao dịch đơn lẻ: cứ để chúng ở Postgres. Dấu hiệu thật sự nằm ở câu hỏi của khách, khi câu hỏi đi theo chuỗi “ai nối với ai, qua cái gì, bao nhiêu bước”.
Các use case mà AWS liệt kê đều có chung hình dạng đó: mạng xã hội, gợi ý sản phẩm, phát hiện gian lận qua email, thẻ và IP dùng chung, tối ưu tuyến đường, quản lý tri thức. Khi nghe khách mô tả bài toán, hãy để ý xem họ có đang mô tả một con đường đi qua nhiều thực thể hay không.
Một vòng gian lận, viết hai cách
Thử hình dung schema relational: bảng accounts, bảng nối account_cards(account_id, card_id) và account_ips(account_id, ip). Tìm tài khoản dùng chung thẻ trực tiếp với tài khoản bị gắn cờ, chỉ riêng một loại thuộc tính, đã cần thế này:
SELECT DISTINCT ac2.account_id
FROM accounts f
JOIN account_cards ac1 ON ac1.account_id = f.id
JOIN account_cards ac2 ON ac2.card_id = ac1.card_id
WHERE f.flagged = true AND ac2.account_id <> f.id;
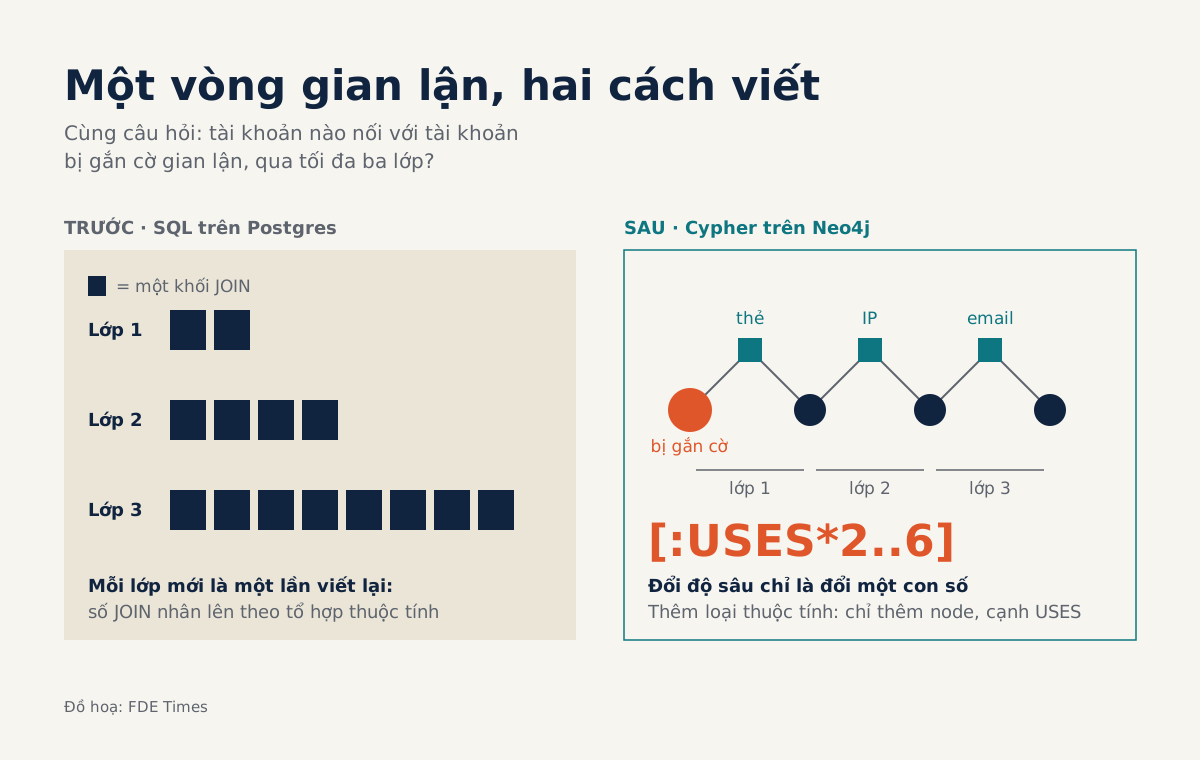
Muốn thêm IP, bạn UNION thêm một khối tương tự. Muốn đi thêm một lớp (A dùng chung thẻ với B, B dùng chung IP với C), số JOIN nhân lên theo từng tổ hợp loại thuộc tính. Mỗi lớp mới là một lần viết lại.
Cùng câu hỏi trong mô hình đồ thị: tài khoản, thẻ, email, IP đều là node; quan hệ USES nối tài khoản với những thứ nó dùng. Truy vấn Cypher trên Neo4j:
MATCH (f:Account {flagged: true})-[:USES*2..6]-(a:Account)
WHERE a <> f
RETURN DISTINCT a.id
Mỗi bước “dùng chung” là hai cạnh (tài khoản tới thẻ, thẻ về tài khoản khác), nên *2..6 nghĩa là đi xa tối đa ba lớp. Đổi độ sâu chỉ là đổi một con số. Thêm loại thuộc tính mới như số điện thoại cũng không cần sửa truy vấn, chỉ cần thêm node và cạnh USES.
Đó là lợi thế bạn cần cho đội risk xem tận mắt. AWS còn quảng bá rằng hiệu năng giữ ổn định khi lượng dữ liệu đồ thị tăng; hãy coi đó là tuyên bố của nhà cung cấp và tự đo trên dữ liệu của khách trước khi hứa hẹn điều gì.
Neo4j hay Neptune: hỏi ngôn ngữ và hạ tầng trước
Ngôn ngữ truy vấn đồ thị hiện còn phân mảnh: Cypher của Neo4j, Gremlin của Apache TinkerPop, SPARQL của W3C dành cho RDF, và GQL là chuẩn ISO. Về mô hình, có hai trường phái chính: labeled property graph (node và cạnh mang thuộc tính, như ví dụ trên) và RDF.
| Khía cạnh | Neo4j | Amazon Neptune |
|---|---|---|
| Mô hình dữ liệu | Property graph | Cả property graph lẫn RDF |
| Ngôn ngữ | Cypher; từ bản 2025.06, tính năng mới chỉ vào Cypher 25, Cypher 5 bị đóng băng | Gremlin, openCypher, SPARQL |
| GraphRAG | Tự định vị là “knowledge layer” cho AI, quảng bá Agentic GraphRAG | GraphRAG được quản lý qua Amazon Bedrock Knowledge Bases |
Về kiến trúc, một cluster Neptune có một instance ghi chính và tối đa 15 read replica, cùng dùng chung một cluster volume trải qua nhiều AZ. Bên cạnh đó còn có Neptune Analytics, một engine phân tích in-memory riêng, bổ trợ cho Neptune database khi cần phân tích lượng lớn dữ liệu đồ thị.
Tại site khách, bảng trên quy về vài câu hỏi rất đời thường. Nếu khách đã chạy mọi thứ trên AWS và đội vận hành không muốn thêm hệ thống mới, Neptune giảm ma sát. Nếu dữ liệu của khách vốn là RDF hoặc ontology ngành, Neptune với SPARQL là lựa chọn tự nhiên.
Nếu đội của khách sẽ tự viết và bảo trì truy vấn lâu dài, Cypher thường dễ đọc với người quen SQL. Vì Neptune hỗ trợ openCypher, bạn có thể viết prototype bằng Cypher rồi kiểm tra lại từng tính năng trước khi chốt nền tảng. Ghi rõ phiên bản Cypher trong tài liệu bàn giao, vì Cypher 5 không còn nhận tính năng mới.
GraphRAG giải quyết loại câu hỏi nào?
Đồ thị còn một chỗ dùng thứ hai: làm nền cho hệ thống hỏi đáp bằng AI. Nghiên cứu GraphRAG của Microsoft cho rằng RAG thông thường thất bại với các câu hỏi bao quát, nhắm vào toàn bộ một kho văn bản. Đó là động lực cho cách tiếp cận dựa trên đồ thị.
Thử hình dung khách có vài nghìn báo cáo sự cố. Câu “sự cố ngày 12 do lỗi gì?” là câu hỏi cục bộ: vector search tìm đúng vài đoạn văn là đủ.
Câu “nguyên nhân nào lặp lại nhiều nhất trong ba năm qua?” thì khác, vì không có đoạn văn nào chứa sẵn câu trả lời, và lấy top-k đoạn giống nhất sẽ chỉ cho một góc nhìn lệch.
Đồ thị giúp ở đây vì nó gom thực thể (thiết bị, nhà cung cấp, loại lỗi) và quan hệ giữa chúng trên toàn kho, để hệ thống trả lời dựa trên cấu trúc thay vì vài đoạn rời rạc. Nhưng nếu 90% câu hỏi của khách là câu cục bộ, GraphRAG chỉ thêm chi phí và độ phức tạp.
Làm từng bước tại site khách
Bắt đầu từ câu hỏi, không từ công cụ. Thu thập 15 đến 20 câu hỏi thật mà khách cần trả lời, đánh dấu câu nào đi qua nhiều bước quan hệ, câu nào bao quát toàn kho tài liệu.
Tiếp theo, vẽ mô hình node và cạnh lên bảng trắng cùng chuyên gia nghiệp vụ của khách. Với ví dụ fintech, chỉ cần bốn loại node và một loại cạnh là đủ để demo. Sau đó nạp một lát dữ liệu thật, viết lại hai hoặc ba câu hỏi khó nhất bằng Cypher hoặc Gremlin, đặt cạnh bản SQL để khách tự so sánh.
Cuối cùng mới chọn nền tảng, dựa trên hạ tầng khách đang có, ngôn ngữ đội của họ sẽ bảo trì, và nhu cầu tách phần phân tích nặng sang engine in-memory như Neptune Analytics.
Những lỗi hay gặp
Lỗi phổ biến nhất là dùng graph database cho dữ liệu vốn là bảng, chỉ vì “GraphRAG đang hot”. Lỗi thứ hai là mô hình hóa mọi thứ thành node, kể cả những thuộc tính lẽ ra chỉ nên là property, khiến đồ thị phình to và truy vấn chậm.
Lỗi thứ ba là để truy vấn độ dài biến thiên không có giới hạn trên, như [:USES*], chạy trên dữ liệu production; trong một mạng dày, nó có thể duyệt gần cả đồ thị. Lỗi thứ tư là tin con số marketing, chẳng hạn mức 100k+ truy vấn mỗi giây mà Neptune quảng bá, thay vì benchmark trên đúng workload của khách.
Với developer Việt Nam muốn chuyển sang FDE, kỹ năng này dễ chứng minh. Một repo nhỏ có cùng câu hỏi viết bằng SQL và Cypher, kèm ghi chú vì sao bạn chọn mô hình đó, nói nhiều hơn dòng “biết Neo4j” trong CV.
Khi đọc JD, nếu thấy bài toán thuộc nhóm use case quen thuộc của graph như phát hiện gian lận, gợi ý hay quản lý tri thức, hãy đưa repo đó lên đầu hồ sơ.
Lần tới khi một câu SQL bắt đầu tự JOIN với chính nó, hãy dừng lại và hỏi khách xem câu hỏi thật của họ đi qua bao nhiêu bước quan hệ.