Đọc model card trước khi chọn Qwen, Llama, Gemma hay Mistral cho dự án tiếng Việt
Model card của Llama 3.1 có tiếng Thái nhưng không có tiếng Việt, và đó là loại chi tiết bạn phải nắm trước khi đưa một mô hình mở vào hệ thống của khách hàng.
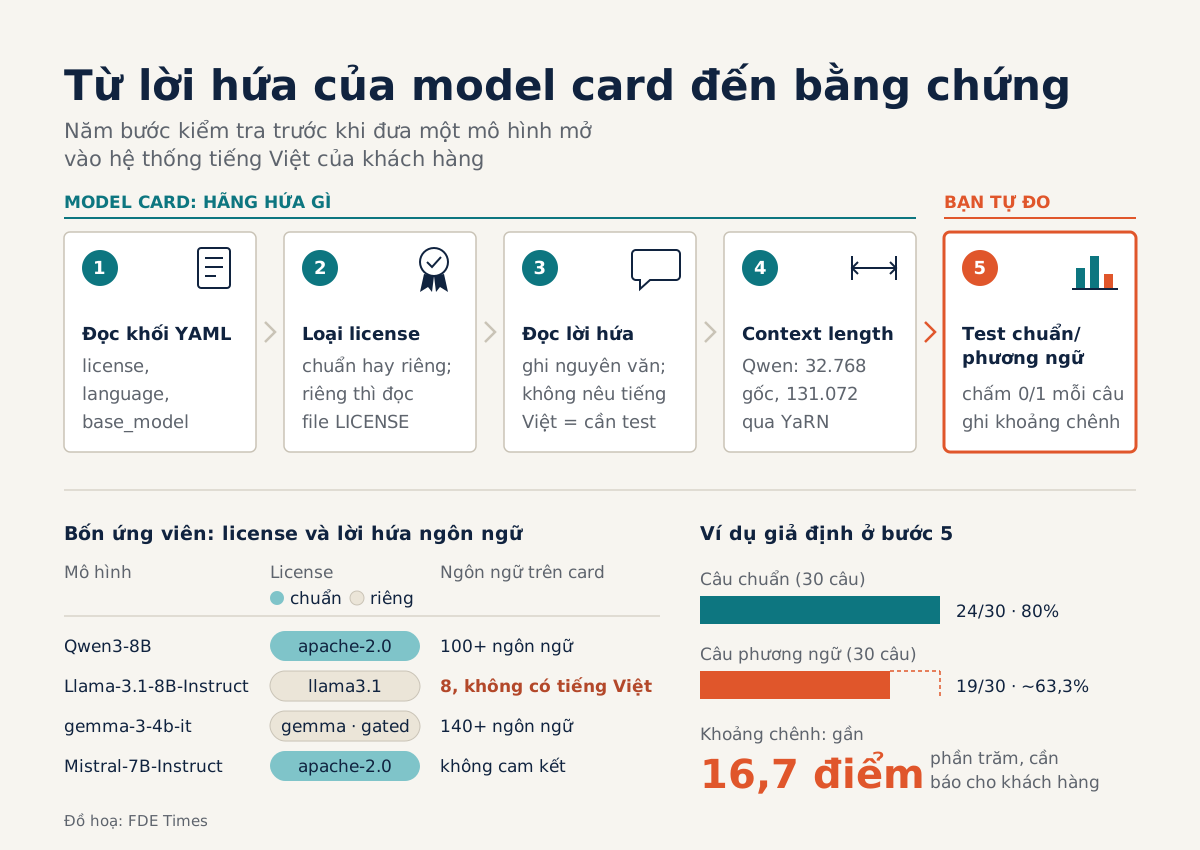
Tóm tắt nhanh
- Model card là README.md có metadata YAML. Trường license cho biết bạn đang dùng license nguồn mở chuẩn hay điều khoản riêng của hãng.
- Qwen3-8B và Mistral-7B-Instruct-v0.3 dùng Apache 2.0. Llama 3.1 và Gemma 3 dùng license riêng, trong đó Gemma còn bắt chấp nhận điều khoản trước khi tải file.
- Không card nào trong bốn mô hình chứng minh được tiếng Việt cho bạn. Hãy đối chiếu với VMLU rồi tự test bằng văn bản có phương ngữ.
Model card của Llama 3.1 8B Instruct liệt kê tám ngôn ngữ được hỗ trợ chính thức. Tiếng Thái có trong danh sách. Tiếng Việt thì không.
Chi tiết đó nằm ngay trên trang mô hình và ai cũng đọc được, vậy mà vẫn rất dễ bị bỏ qua khi một team đã quyết định “dùng Llama vì nó phổ biến”. Ở vị trí FDE, bạn thường là người phải trả lời câu hỏi của khách hàng: mô hình mở nào dùng được cho tiếng Việt, và về mặt pháp lý có được phép dùng hay không.
Bài này hướng dẫn bạn tự tìm câu trả lời đó trong model card, sau đó kiểm tra lại bằng dữ liệu của chính bạn.
Một buổi tối, một bảng vừa một trang
Cuối buổi, bạn sẽ có một bảng so sánh vừa một trang giấy cho bốn ứng viên: Qwen3-8B, Llama-3.1-8B-Instruct, gemma-3-4b-it và Mistral-7B-Instruct-v0.3. Mỗi mô hình có license, điều card cam kết về ngôn ngữ và rủi ro cần tự kiểm tra, cộng thêm kết quả test tiếng Việt do chính bạn đo.
Bạn cần một tài khoản Hugging Face, vì Gemma đòi chấp nhận điều khoản trước khi cho tải file. Ngoài ra cần một trình soạn thảo để ghi chép, và sau cùng là quyền chạy thử ít nhất hai mô hình, có thể qua bất kỳ môi trường inference nào bạn đang dùng. Các bước đọc card thì chỉ cần trình duyệt.
Bước 1: Mở README.md và đọc khối YAML trước
Tài liệu Hugging Face viết rằng model card của mọi repo chính là file README.md, gồm Markdown cộng thêm metadata. Phần metadata là một khối YAML ở đầu file, chứa những trường như license, language, datasets và base_model. Bạn nên đọc khối này trước, vì nó là dữ liệu có cấu trúc, còn phần văn xuôi phía dưới là lời hãng tự giới thiệu.
Dưới đây là một khối YAML minh họa, đã được rút gọn và không chép từ repo nào:
---
license: apache-2.0
language:
  - en
base_model: some-org/some-base-model
datasets:
  - some-dataset
---
Kiểm tra: với mỗi mô hình, ghi giá trị license vào bảng. Nếu card có base_model, hãy ghi lại luôn và mở thêm card của mô hình gốc để đọc license của nó. Trước khi trả lời khách hàng, bạn cần nắm điều khoản của cả bản đang dùng lẫn mô hình gốc.
Bước 2: Phân loại license trước khi bàn đến chất lượng
Trên Hub, license được hiện ngay trên trang mô hình và có thể dùng để lọc. Điều quan trọng là Hub dùng các mã riêng cho Llama (llama3.1, llama3.3, llama4) và cho Gemma (gemma), tách biệt với các license chuẩn như apache-2.0. Vì vậy, chỉ cần nhìn trường này là bạn biết mình đang dùng license nguồn mở chuẩn hay điều khoản riêng của một hãng.
Trường hợp khó nhất là license tùy biến, được khai báo như sau (minh họa):
---
license: other
license_name: ten-license-rieng
license_link: LICENSE
---
Với license: other, Hub yêu cầu đặt toàn văn license vào file LICENSE trong repo. Đừng chỉ tin vào cái badge mà hãy mở file đó hoặc link trong license_link ra đọc.
Áp vào bốn mô hình: Qwen3-8B và Mistral-7B-Instruct-v0.3 dùng Apache 2.0. Llama 3.1 dùng license cộng đồng riêng, có điều khoản bắt sản phẩm vượt 700 triệu người dùng hoạt động hàng tháng phải xin license từ Meta, và đi kèm một acceptable-use policy quy định cách dùng.
Gemma 3 dùng Gemma Terms of Use và là repo gated, nghĩa là bạn phải đồng ý điều khoản mới tải được file.
Kiểm tra: trong bảng, cột license chỉ có hai giá trị: “chuẩn” hoặc “riêng, đã đọc toàn văn”. Nếu còn ô ghi “riêng, chưa đọc” thì bạn chưa được sang bước 3.
Bước 3: Đọc phần ngôn ngữ như đọc một lời hứa
Card của Qwen3-8B viết rằng mô hình hỗ trợ hơn 100 ngôn ngữ và phương ngữ, nhưng không nêu tên tiếng Việt. Gemma 3 4B-it nói về khả năng đa ngôn ngữ cho hơn 140 ngôn ngữ. Llama 3.1 có tám ngôn ngữ chính thức và không có tiếng Việt.
Card của Mistral-7B-Instruct-v0.3 không đưa ra cam kết đa ngôn ngữ nào, và còn nói rõ mô hình không có cơ chế kiểm duyệt (moderation) nào.
Có hai loại tín hiệu ở đây và bạn cần tách chúng ra. Với Llama, dùng tiếng Việt nghĩa là bạn đang dùng ngoài phạm vi hãng hỗ trợ chính thức, và khách hàng cần được báo trước điều đó. Với Qwen và Gemma, những con số 100 hay 140 cho biết độ rộng, nhưng không chứng minh được chất lượng tiếng Việt cho bài toán cụ thể của bạn.
Kiểm tra: ghi nguyên văn câu về ngôn ngữ của từng card vào bảng, không diễn giải thêm. Câu nào không nhắc tới tiếng Việt thì đánh dấu “cần test”.
Bước 4: Ghi context length và giới hạn vận hành
Qwen3-8B có context gốc 32.768 token, mở rộng được tới 131.072 token nhờ YaRN. Gemma 3 có cửa sổ context 128K. Hai con số này quan trọng khi khách hàng muốn đưa cả một hợp đồng hay một bộ hồ sơ dài vào prompt.
Con số mở rộng thường đi kèm cấu hình riêng, vì vậy hãy ghi cả hai giá trị của Qwen thay vì chỉ ghi con số lớn hơn. Với Llama và Mistral, hãy tự mở card để điền context thay vì đoán. Phần cốt lõi của bảng sau bước này sẽ giống như sau:
| Mô hình | License | Card nói gì về ngôn ngữ | Rủi ro cần test |
|---|---|---|---|
| Qwen3-8B | apache-2.0 | 100+ ngôn ngữ, không nêu tên tiếng Việt | Chất lượng tiếng Việt thực tế |
| Llama-3.1-8B-Instruct | llama3.1 (riêng) | 8 ngôn ngữ, không có tiếng Việt | Ngoài phạm vi hỗ trợ, điều khoản 700 triệu MAU |
| gemma-3-4b-it | gemma (riêng, gated) | Hơn 140 ngôn ngữ | Điều khoản Gemma, chất lượng tiếng Việt |
| Mistral-7B-Instruct-v0.3 | apache-2.0 | Không có cam kết | Không có moderation, tiếng Việt chưa rõ |
Bước 5: Đối chiếu với nguồn độc lập, rồi tự chấm với phương ngữ
Card là lời hãng tự nói về mình, nên bạn cần một nguồn bên ngoài. VMLU là bộ benchmark tiếng Việt đã qua bình duyệt, được công bố tại ACL 2025, và có so sánh các mô hình như Llama-3, Qwen2.5 và GPT-4. Hãy dùng nó để biết sơ bộ họ mô hình nào mạnh về tiếng Việt.
Lưu ý rằng phiên bản trong benchmark có thể khác phiên bản bạn định dùng.
Tiếp theo là phần mà benchmark chuẩn không bao quát hết. VialectBench, công bố trên arXiv tháng 8/2026, cho thấy phương ngữ vùng miền làm giảm hiệu năng của LLM: trung bình giảm khoảng 2,82% trên mười mô hình instruction-tuned, và không mô hình nào hoàn toàn vững. Người dùng thật của khách hàng sẽ không viết như sách giáo khoa.
Vì vậy hãy tự dựng một bộ test nhỏ và chấm điểm theo quy tắc đơn giản: câu trả lời đúng ý định trong cột đáp án thì được 1, sai hoặc lạc đề thì 0. Định dạng dưới đây do bạn tự đặt, không phải chuẩn của bên nào, và hai dòng điểm chỉ là minh họa:
id,cau_chuan,cau_phuong_ngu,dap_an_mong_doi,diem_chuan,diem_phuong_ngu
1,"Tôi muốn đổi địa chỉ giao hàng","Tui muốn đổi chỗ giao hàng nghen","Hướng dẫn đổi địa chỉ",1,1
2,"Đơn của tôi bao giờ tới?","Đơn tui chừng nào tới rứa?","Tra cứu trạng thái đơn",1,0
Thử hình dung bạn chạy 30 cặp câu trên một mô hình. Giả sử cột chuẩn đúng 24/30, tức 80%, còn cột phương ngữ chỉ đúng 19/30, tức khoảng 63,3%. Khoảng chênh là 5 câu, gần 16,7 điểm phần trăm.
Con số giả định đó mới là thứ bạn đem đi báo cáo, không phải điểm 80%. Hãy đọc lại 5 câu bị trượt để xem mô hình vấp ở từ địa phương, ở trợ từ cuối câu hay ở cách viết không dấu. Mỗi nhóm lỗi gợi ý một cách xử lý khác nhau, từ chuẩn hóa đầu vào đến thêm ví dụ vào prompt.
Kiểm tra: chạy cùng bộ câu hỏi trên ít nhất hai mô hình, ghi ba con số cho mỗi mô hình: điểm cột chuẩn, điểm cột phương ngữ và khoảng chênh. Nếu khoảng chênh lớn, đó là phát hiện mà khách hàng cần biết trước khi ra mắt sản phẩm.
Những lỗi hay gặp nhất là gì?
Lỗi thứ nhất là tin vào badge. Một repo khai báo license: other có thể chứa bất cứ điều khoản nào, và chỉ file LICENSE mới cho biết điều khoản đó là gì. Lỗi thứ hai là coi “hơn 100 ngôn ngữ” là bằng chứng cho tiếng Việt, trong khi card của Qwen3-8B không hề nêu tên tiếng Việt.
Lỗi thứ ba là quên kiểm tra license của mô hình gốc khi dùng một bản fine-tune tiếng Việt do cộng đồng làm ra. Lỗi thứ tư là chọn Mistral vì Apache 2.0 rồi đưa thẳng ra cho người dùng cuối, trong khi chính card nói rằng mô hình không có cơ chế kiểm duyệt. Trường hợp này bạn cần tự thêm một lớp lọc phía trước.
Kỹ năng này xuất hiện ở đâu khi làm cho khách hàng?
Hãy hình dung một ngân hàng muốn chạy chatbot nội bộ trên hạ tầng riêng. Trong buổi họp đầu tiên, câu hỏi từ bộ phận pháp chế sẽ đến trước câu hỏi về độ chính xác: “license này cho phép chúng tôi làm gì?”.
Nếu bạn mang theo bảng ở bước 4, cùng toàn văn các license riêng đã được đánh dấu và ba con số test ở bước 5, buổi họp sẽ chuyển ngay sang chuyện kỹ thuật.
Nếu muốn đưa kỹ năng này vào CV, đừng viết “có kinh nghiệm với LLM”. Hãy viết rằng bạn đã đánh giá license và khả năng tiếng Việt của bốn mô hình mở, có bộ test riêng cho phương ngữ, và ghi kèm khoảng chênh điểm bạn đo được.
Khi đọc JD, nếu thấy các cụm như “model selection”, “evaluation” hay “compliance review”, đó chính là công việc bạn vừa làm.
Lần tới khi ai đó hỏi “dùng Llama hay Qwen”, bạn có thể trả lời bằng một bảng đầy đủ license, ngôn ngữ và kết quả test, chứ không chỉ bằng cảm tính.
8 nguồn
- Model Cards (Hugging Face Hub docs)
- Licenses (Hugging Face Hub docs)
- Qwen/Qwen3-8B · Hugging Face
- meta-llama/Llama-3.1-8B-Instruct · Hugging Face
- google/gemma-3-4b-it · Hugging Face
- mistralai/Mistral-7B-Instruct-v0.3 · Hugging Face
- VMLU Benchmarks: A comprehensive benchmark toolkit for Vietnamese LLMs · 2025-07
- How Robust Are LLMs to Vietnamese Dialects? · 2026-08-11