Thực hành agentic RAG: cho agent tự viết lại truy vấn và từ chối trả lời khi thiếu bằng chứng
Hệ RAG cơ bản tìm một lần rồi trả lời bằng bất cứ thứ gì nó tìm được. Bài này dựng thêm một vòng lặp nhỏ để agent tự kiểm tra bằng chứng, và nếu chưa đủ thì tự sửa câu hỏi rồi tìm lại.
Tóm tắt nhanh
- RAG cơ bản nhúng câu hỏi rồi so khớp với vector database đúng một lần. Agentic RAG biến bước truy xuất thành một tool mà agent tự quyết định có gọi hay không.
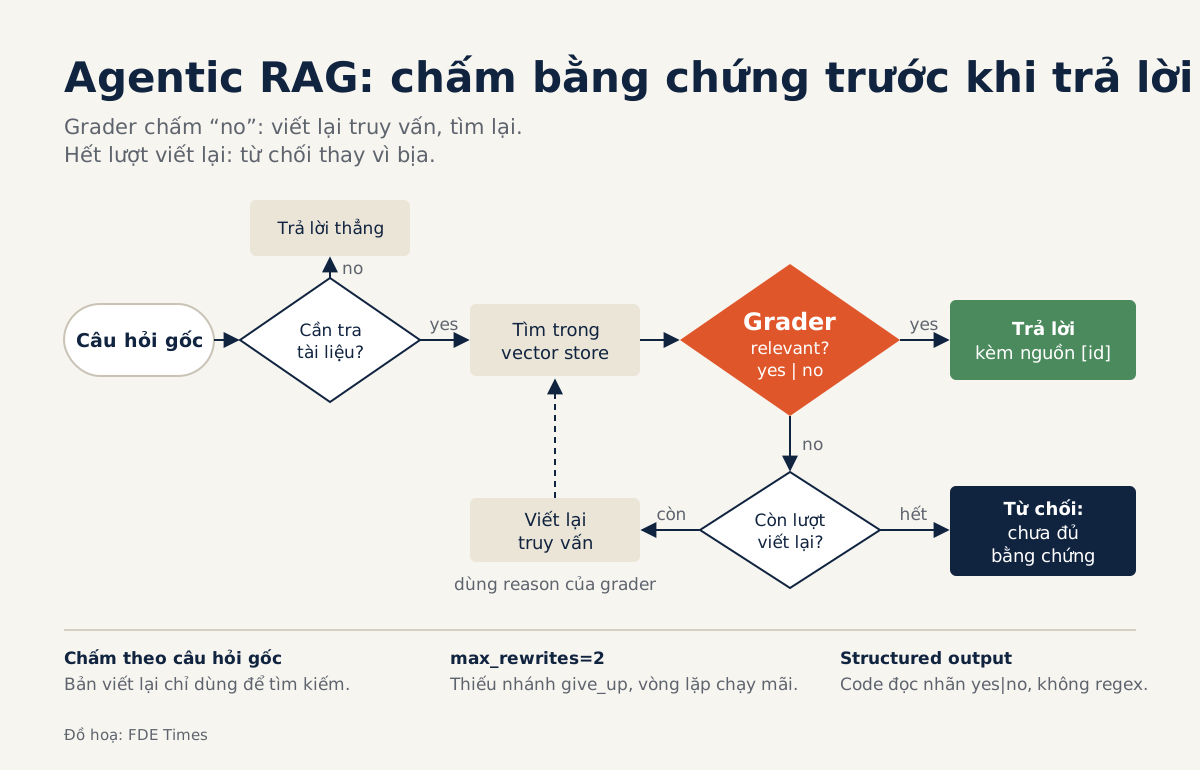
- Một grader trả về structured output sẽ quyết định nhánh đi tiếp. Nếu tài liệu không liên quan, hệ thống không được trả lời từ đó mà phải viết lại câu hỏi.
- Ở chỗ khách hàng, vòng lặp cần giới hạn số lần thử, có lối thoát kiểu "chưa đủ bằng chứng" và câu trả lời kèm nguồn.
Tài liệu hướng dẫn agentic RAG của LangGraph có một quy tắc nghe hiển nhiên: nếu grader đánh giá tài liệu tìm được là không liên quan, graph không được trả lời dựa trên ngữ cảnh đó. Thay vào đó, nó viết lại câu hỏi rồi tìm lại.
Bạn nên để ý quy tắc này vì nó chặn đúng một kiểu câu trả lời “bịa” rất dễ hình dung của RAG. Mô hình nhận vài đoạn văn gần đúng rồi cố trả lời bằng chính những đoạn đó. Nếu bạn làm FDE, đây là loại lỗi đáng chặn trước khi khách hàng tự phát hiện ra.
Bài này đi từ một pipeline RAG đơn giản đến một vòng lặp gồm quyết định, chấm điểm và viết lại. Toàn bộ code là phác thảo đã được đơn giản hoá bằng Python thuần. retrieve(), llm() và llm_structured() là các hàm bạn tự nối vào vector store và model đang dùng, không phải API của thư viện nào.
Bạn sẽ dựng gì, và cần chuẩn bị gì?
Lấy một ví dụ giả định: chatbot tra cứu quy chế nhân sự của một công ty. Nhân viên hỏi: “Nhân viên thử việc có được nghỉ phép năm không?”. Vector search trả về ba đoạn nói về nghỉ phép của nhân viên chính thức. Ba đoạn này rất giống câu hỏi về mặt ngữ nghĩa, nhưng không trả lời được nó.
Bạn cần chuẩn bị ba thứ: một vector store đã nạp tài liệu, một model có thể trả về JSON theo schema, và khoảng 20 câu hỏi thật kèm đáp án đúng. Bộ câu hỏi này là thứ quý nhất, vì nếu không có nó, bạn không có cách nào biết vòng lặp có giúp ích hay không.
Bước 1: Dựng baseline truy xuất một lần
AWS mô tả RAG cơ bản như sau: câu hỏi được chuyển thành vector rồi so khớp với vector database. Việc so khớp chỉ diễn ra một lần.
def simple_rag(question):
    docs = retrieve(question)   # nhúng câu hỏi, so khớp một lần
    return llm(f"Trả lời dựa trên:\n{docs}\n\nCâu hỏi: {question}")
Kiểm tra: chạy bộ 20 câu và ghi lại số câu đúng. Với câu hỏi về nhân viên thử việc, nhiều khả năng baseline sẽ tự tin trả lời theo quy định dành cho nhân viên chính thức. Hãy giữ lại con số này để so sánh ở cuối bài.
Bước 2: Để agent quyết định có cần tìm hay không
Hướng dẫn của LangGraph dựng một retrieval agent tự quyết định khi nào tìm trong vector store và khi nào trả lời thẳng. Lúc này truy xuất là một lần gọi tool chứ không còn là một bước cố định.
def decide(question):
    v = llm_structured(
        prompt=f"Câu hỏi này có cần tra tài liệu nội bộ không? {question}",
        schema={"need_search": "yes|no"},
    )
    return v["need_search"] == "yes"
Kiểm tra: những câu chào hỏi như “cảm ơn bạn” phải đi thẳng sang nhánh trả lời, còn mọi câu hỏi về quy chế phải đi sang nhánh tìm kiếm. Nếu agent bỏ qua bước tìm với một câu hỏi về quy chế, hãy sửa prompt trước khi làm tiếp.
Bước 3: Viết grader trả về structured output
Đây là phần cốt lõi. Trong tutorial, LangGraph chấm tài liệu bằng một hàm định tuyến, và hàm này dùng một model có structured output schema. Lý do rất thực tế: code cần đọc được một nhãn rõ ràng, không thể đi phân tích một đoạn văn kiểu “có vẻ khá liên quan”.
GRADE_SCHEMA = {"relevant": "yes|no", "reason": "str"}

def grade(question, docs):
    return llm_structured(
        prompt=f"Các đoạn sau có trả lời được câu hỏi không?\n{docs}\n\nCâu hỏi: {question}",
        schema=GRADE_SCHEMA,
    )
Trường reason là lựa chọn thiết kế của phác thảo này: nó giúp bước viết lại biết lần tìm trước hỏng ở đâu.
Ý tưởng chấm bằng chứng cũng có nền tảng học thuật. Bài báo Corrective RAG (CRAG) thêm một bộ đánh giá gọn nhẹ để chấm chất lượng tổng thể của tài liệu tìm được cho một câu hỏi, rồi dựa vào mức độ tin cậy mà bộ này trả về để chọn cách truy xuất tiếp theo.
Kiểm tra: với ví dụ thử việc, grader phải trả về "no" cùng một lý do đại loại như “tài liệu chỉ nói về nhân viên chính thức”. Nếu grader gắn "yes" cho mọi thứ, prompt chấm của bạn đang quá dễ dãi.
Bước 4: Định tuyến bằng trạng thái
LangGraph dùng conditional edge, tức là chọn node tiếp theo lúc runtime bằng cách chạy một hàm trên state hiện tại. Phiên bản Python thuần dưới đây làm đúng việc đó.
def route(state):
    if state["grade"]["relevant"] == "yes":
        return "generate"
    if state["rewrites"] >= state["max_rewrites"]:
        return "give_up"
    return "rewrite"
Nhánh give_up cũng là một lựa chọn thiết kế của phác thảo này. Nếu thiếu nó, một câu hỏi mà kho tài liệu không có lời đáp sẽ khiến hệ thống lặp mãi.
Bước 5: Viết lại truy vấn và khép vòng lặp
Hàm viết lại nhận lý do thất bại từ grader:
def rewrite(question, reason):
    return llm(f"Viết lại câu hỏi để tìm kiếm tốt hơn. "
               f"Lần trước thất bại vì: {reason}\nCâu hỏi: {question}")
Hàm chính quyết định có tìm hay không, rồi khởi tạo state:
def agentic_rag(question, max_rewrites=2):
    if not decide(question):
        return llm(question)
    s = {"query": question, "rewrites": 0, "max_rewrites": max_rewrites}
    return loop(question, s)
Vòng lặp tìm, chấm và định tuyến:
def loop(question, s):
    while True:
        s["docs"] = retrieve(s["query"])
        s["grade"] = grade(question, s["docs"])  # chấm theo câu hỏi gốc
        nxt = route(s)
        if nxt == "generate":
            return answer_with_sources(question, s["docs"])
        if nxt == "give_up":
            return "Chưa tìm đủ bằng chứng trong tài liệu để trả lời."
        s["query"] = rewrite(s["query"], s["grade"]["reason"])
        s["rewrites"] += 1
Bạn nên chú ý một chi tiết: grader luôn chấm theo câu hỏi gốc, không chấm theo bản đã viết lại. Bản viết lại chỉ dùng để tìm kiếm. Làm vậy giữ cho vòng lặp không trôi dần sang một câu hỏi khác dễ trả lời hơn.
Kiểm tra: in ra chuỗi truy vấn của câu hỏi thử việc. Lần thứ hai nên ra một truy vấn kiểu “chính sách nghỉ phép áp dụng cho nhân viên thử việc”, và lần này grader nên trả "yes".
Bước 6: Trả lời kèm nguồn
AWS liệt kê việc ghi nguồn là một lợi ích của RAG. Khi đã chấm bằng chứng, việc ghi nguồn còn là cách để người dùng tự kiểm tra lại grader.
def answer_with_sources(question, docs):
    ctx = "\n".join(f"[{d['id']}] {d['text']}" for d in docs)
    return llm(f"Chỉ dùng các đoạn dưới đây, ghi [id] sau mỗi ý.\n{ctx}\n\nCâu hỏi: {question}")
Kiểm tra: chạy lại bộ 20 câu và so với baseline ở bước 1. Ngoài số câu đúng, bạn cần đếm thêm hai thứ: số câu hệ thống từ chối mà đáng lẽ phải trả lời được, và số câu hệ thống trả lời mà đáng lẽ phải từ chối.
Lỗi nào hay gặp nhất?
Lỗi thứ nhất là để grader trả về văn bản tự do rồi dùng regex để đoán nhãn. Hệ thống sẽ chạy ổn trong demo rồi hỏng khi gặp câu trả lời kiểu “có, nhưng chưa đầy đủ”. Lỗi thứ hai là vòng lặp không có giới hạn. Với câu hỏi nằm ngoài kho tài liệu, chi phí model sẽ tăng lên mà không đem lại gì.
Lỗi thứ ba khó thấy hơn: bản viết lại giữ được từ khoá nhưng làm mất điều kiện. Chẳng hạn chữ “thử việc” biến mất, và câu hỏi lại quay về dạng chung chung. Muốn bắt lỗi này, bạn nên đọc trace của từng lần viết lại thay vì chỉ nhìn câu trả lời cuối.
Self-RAG đi theo một hướng khác: huấn luyện chính model để nó chỉ truy xuất khi cần và tự phê bình bằng các reflection token đặc biệt. Vòng lặp trong bài này thì không cần huấn luyện gì, nên ở chỗ khách hàng nó dễ đưa vào hơn: model nào hỗ trợ structured output cũng chạy được.
Kỹ năng này xuất hiện thế nào ở chỗ khách hàng?
NVIDIA nhìn tương lai của RAG theo hướng LLM và kho tri thức được điều phối động để tạo thành các trợ lý tự hành. Dù vậy, bạn nên chuẩn bị cho khả năng cuộc trao đổi với khách không bắt đầu từ kiến trúc, mà từ một lời phàn nàn cụ thể kiểu “bot trả lời sai về chính sách X”.
Việc đầu tiên bạn nên làm là bật trace, rồi chỉ cho khách thấy grader đã nói “no” ở đâu và hệ thống đã làm gì sau đó.
Trong CV, đừng chỉ viết “xây dựng chatbot RAG”. Hãy viết rằng bạn đã thêm bước chấm bằng chứng và viết lại truy vấn, rồi đo được số câu bị trả lời sai giảm đi bao nhiêu trên bộ câu hỏi thật của người dùng.
Người phỏng vấn có thể hỏi bạn đã xử lý thế nào với câu hỏi không có lời đáp trong kho tài liệu. Khi đó, nhánh give_up cùng trace của nó là câu trả lời tốt hơn bất kỳ slide nào.